第 8 章:第七周(上):用 LangGraph 把 RAG 变成会决策的 Agent
第 8 章:第七周(上):用 LangGraph 把 RAG 变成会决策的 Agent
到第 6 周为止,系统的形状是固定的:查询进来,先查 Redis cache,未命中就走 Hybrid Search 取回一批 chunk,拼进 prompt 交给 Ollama。链路上没有任何一个环节会问一句"这一步真的有必要吗"。第七周拆掉的就是这个前提——把写死的流水线换成一张会在运行时决定下一步走哪里的状态图。这一章看的是决策怎么被拆成节点、节点之间怎么连、以及决策过程怎么暴露给人看。
传统 RAG 与 Agentic RAG:差别在谁做决定
源材料用两段伪代码把差别压得很清楚:
Traditional RAG (Weeks 5-6):
Query → Always Retrieve → Generate Answer
Agentic RAG (Week 7):
Query → Agent Decides:
├─ Simple question? → Respond directly (faster!)
└─ Research needed? → Retrieve
├─ Relevant docs? → Generate answer
└─ Not relevant? → Rewrite query → Try again三处变化:检索从"必经"变成"可选",检索结果从"直接塞进 prompt"变成"先打分再决定用不用",一次失败从"就这样答吧"变成"改写查询再试一轮"。Week 7 README 给了一张逐维度对比表:
| Feature | Traditional RAG | Agentic RAG |
|---|---|---|
| Retrieval | Always retrieves | Decides when needed |
| Relevance Check | None | Grades documents |
| Query Refinement | None | Rewrites if needed |
| Iterations | Single pass | Multiple attempts |
| Transparency | Black box | Shows reasoning |
| Simple Questions | ~15-20s | ~2-5s (no retrieval) |
| Complex Questions | Single attempt | Iterative refinement |
表里的时间数字是课程本地环境(Docker Compose + 本地 Ollama)下的观察值,不是通用 benchmark,读的时候要注意口径。其中 ~15-20s 与 Week 7 README 性能基准表里的 First Query 15-20s 是同一口径;~2-5s 那一格省掉的不是某一次搜索的耗时,而是整条 retrieve + grade + generate 链路。
代价同样直接:Single pass 变成 Multiple attempts 之后,单次请求的延迟不再是可以预估的常数,它取决于 Agent 决定绕几圈。生产上这意味着超时、并发和成本估算都要按最坏情况留余量。
LangGraph 状态图:节点、边与条件路由
Week 7 的编排用 LangGraph,源材料给出的流程图如下(节点目录为 src/services/agents/):
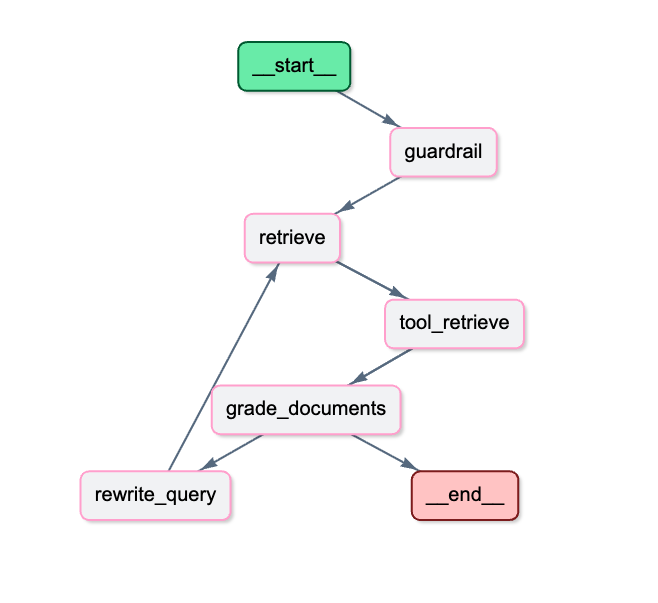
LangGraph Workflow:

START
  ↓
generate_query_or_respond
  ├─ No retrieval needed → END (direct response)
  └─ Needs retrieval → retrieve (ToolNode)
       ↓
     grade_documents
       ├─ Relevant → generate_answer → END
       └─ Not relevant → rewrite_query → (loop back)
图里有两种边。普通边是确定的下一步;从 generate_query_or_respond 和从 grade_documents 出去的两条是条件边,读当前 state 再决定往哪走。前者决定"要不要检索",后者决定"检索结果能不能用"——Agent 的决策能力就落在这两个判断点上,其余都是管道。
README 强调实现遵循 2025 年的 LangGraph 写法:MessagesState 作状态容器,检索封装成 ToolNode,路由判断用 tools_condition。用框架自带的原语,条件路由和消息累加就不用自己手写,节点才能压到很短。
这里有一个源材料内部的口径差异值得记下来:顶层 README 在 Agentic RAG 基础设施清单里,把节点目录 src/services/agents/nodes/ 描述为包含 Guardrail、retrieve、grade、rewrite、generate;而 Week 7 README 的 "What We Built" 把 nodes.py 写成 "4 graph nodes (query, grade, rewrite, generate)"。两处对节点集合的说法并不一致,读代码时以 agentic_rag.py 里实际注册进图的对象为准,不要照抄任一份清单。
各类节点的职责
每个节点只做一件事,这是源材料列出的设计原则里 KISS 那条的具体体现——README 明确写了节点保持在 30 行以内。
- guardrail:查询校验与域边界检测,判断问题是否落在 arXiv 论文这个域内,域外的在进入检索之前就被拦下。这是最便宜的一道防幻觉闸门:与其让 LLM 在没有证据时硬编答案,不如在入口承认"这不在我负责的范围"。
- retrieve:
tools.py把 OpenSearch 包成 retriever tool,由图以ToolNode调用。Week 3 到 Week 5 攒下的 BM25、Hybrid Search 能力在这里被复用,检索逻辑没有重写。 - grade:对取回的文档做语义相关性打分,输出"这些结果够不够用"的判断。它是整张图的枢纽,决定直接生成还是走回退。
- rewrite:查询重写,针对的是"检索没命中"这个失败模式——把过于宽泛的问法改写成更能命中索引的查询,而不是原样重试。
- generate:拿着通过打分的文档生成最终答案。
代码组织如下,~750 LOC 是 README 自己给出的规模口径:
src/services/agents/
├── tools.py            # Retriever tool wrapping OpenSearch
├── nodes.py            # 4 graph nodes (query, grade, rewrite, generate)
├── agentic_rag.py      # LangGraph workflow + service
├── prompts.py          # LLM prompt templates
└── factory.py          # Dependency injection

src/routers/
└── agentic_ask.py      # FastAPI endpoint
factory.py 做依赖注入,prompts.py 单独放 LLM prompt 模板。prompt 与节点逻辑分离,调 prompt 就不必动图结构;依赖构造抽出来,节点才能在不启动整套 Docker 服务的前提下被单独测试。README 把这几条归到 SOLID 与 Explicit(类型标注、docstring、命名清晰)下面,DRY 指复用已有的 OpenSearch、Ollama、Jina 服务,YAGNI 指只实现当下需要的节点。
自适应检索:首轮不足时的多轮与回退
自适应检索的完整语义是:grade_documents 判定不相关时,控制流不回 retrieve,而是先到 rewrite_query,改写后的查询再触发一次检索,然后重新打分。回退不是"重试同一个请求",是"换一个问法再试"。
响应体里的 retrieval_attempts 字段就是给这段循环计数的——调用方据此知道这次答案是在第一轮就命中,还是绕了几圈。这个计数在生产里的作用比它看起来重要:它是区分"自适应检索正常工作"和"循环没有出口"的唯一外部信号。
源材料的流程图只画了回环,没有画终止判断,停止条件是要自己补的护栏。要小心两件事:改写后的查询可能与首轮高度相似,图会在两个节点之间空转;每一轮回退都是一次完整检索加一次打分,延迟和算力按轮数增长。可靠的做法是把 retrieval_attempts 当预算用,到上限就带着已知结果降级回答。
把推理过程暴露出来
源材料把 "Reasoning Transparency" 列为 Week 7 的核心特征之一:把 Agent 的决策步骤显式返回,用于调试和建立信任。API 响应里的 reasoning_steps 是一个自然语言字符串数组,例如:
"reasoning_steps": [
  "Decided to retrieve relevant papers",
  "Retrieved documents from database",
  "Generated answer from relevant documents"
]直接返回给最终用户是次要的用法,真正有用的是排障:答案不对时,reasoning_steps 能把"检索没找到"、"找到了但打分判错"、"文档没问题但生成跑偏"三种失败区分开——这三种情况在传统 RAG 的响应里长得完全一样,都是一个看起来自信的错误答案。第 6 章的 Langfuse trace 给的是延迟与成本视角的分层信息,reasoning_steps 给的是决策时间线,两者互补。
新的 agentic 端点
Week 7 新增 POST /api/v1/ask-agentic,路径上与第 5 章的 /api/v1/ask、/api/v1/stream 并存,传统链路没有被替换掉。请求体:
{
  "query": "What are transformers in ML?",
  "top_k": 3,
  "use_hybrid": true
}
响应体:
{
  "query": "What are transformers in ML?",
  "answer": "Transformers are neural network architectures...",
  "sources": ["https://arxiv.org/pdf/1706.03762.pdf"],
  "chunks_used": 3,
  "search_mode": "hybrid",
  "reasoning_steps": [
    "Decided to retrieve relevant papers",
    "Retrieved documents from database",
    "Generated answer from relevant documents"
  ],
  "retrieval_attempts": 1
}
请求参数与第 4 章的 Hybrid Search、第 5 章的 ask 端点保持一致(top_k、use_hybrid),响应则多了 reasoning_steps 和 retrieval_attempts 两组与决策相关的字段,search_mode 回显实际走的是 hybrid 还是 BM25。直接回答、不检索的那条路径同样返回这个结构,只是 sources 和 chunks_used 为空。
从命令行验证时,README 给的两个例子刚好覆盖两条路径:
# Simple question (should respond directly)
curl -X POST http://localhost:8000/api/v1/ask-agentic \
  -H "Content-Type: application/json" \
  -d '{
    "query": "What is 2+2?",
    "top_k": 3,
    "use_hybrid": true
  }'

# Research question (should retrieve papers)
curl -X POST http://localhost:8000/api/v1/ask-agentic \
  -H "Content-Type: application/json" \
  -d '{
    "query": "What are attention mechanisms?",
    "top_k": 3,
    "use_hybrid": true
  }'
交互式验证走 notebook:
jupyter notebook notebooks/week7/week7_agentic_rag.ipynb典型测试场景
源材料列了三个场景,每个场景都指定了期望行为和期望的 reasoning_steps。这种写法的好处是断言对象不是答案文本(答案文本本来就会漂),而是决策路径:
| 场景 | Query | Expected | Reasoning |
|---|---|---|---|
| Scenario 1: Direct Response (No Retrieval) | "What is 5 + 7?" | Agent responds "12" without retrieving papers | "Responded directly without retrieval" |
| Scenario 2: Successful Retrieval | "What are transformers in machine learning?" | Agent retrieves papers, grades as relevant, generates answer | "Decided to retrieve" → "Retrieved documents" → "Generated answer" |
| Scenario 3: Query Rewriting | "Tell me about ML stuff" (vague) | Agent retrieves, grades as not relevant, rewrites query, tries again | "Retrieved" → "Not relevant" → "Rewritten query" → "Retrieved again" → "Generated answer" |
场景 1 验证最短路径能走通,也是延迟收益的落点。场景 2 验证正常闭环。场景 3 最有价值,因为只有真的发生了回退它才会通过——用故意含糊的查询触发 grade 判负,再看 retrieval_attempts 是否大于 1。
参考链接
- 顶层 README:https://github.com/jamwithai/production-agentic-rag-course/blob/main/README.md
- LangGraph 工作流与 Agentic RAG 服务:https://github.com/jamwithai/production-agentic-rag-course/blob/main/src/services/agents/agentic_rag.py
- Agentic RAG 端点:https://github.com/jamwithai/production-agentic-rag-course/blob/main/src/routers/agentic_ask.py
- Week 7 notebook:https://github.com/jamwithai/production-agentic-rag-course/blob/main/notebooks/week7/week7_agentic_rag.ipynb
- Week 7 notebook 说明(其中列出了下面的实现计划/测试计划文档名):https://github.com/jamwithai/production-agentic-rag-course/blob/main/notebooks/week7/README.md
- 说明:Week 7 README 提到的
docs/AGENTIC_RAG_IMPLEMENTATION_PLAN.md、docs/AGENTIC_RAG_TESTING_PLAN.md、docs/LANGGRAPH_2025_BEST_PRACTICES.md在仓库当前的文件树里并不存在,所以这里不给链接——阅读时以上面的 notebook 和src/services/agents/下的代码为准。 - 对应博客:https://jamwithai.substack.com/p/agentic-rag-with-langgraph-and-telegram
- 对应 release tag:https://github.com/jamwithai/arxiv-paper-curator/releases/tag/week7.0
release 链接出自源材料原文,源 README 里的仓库名写作 jamwithai/arxiv-paper-curator,与课程主仓库名 production-agentic-rag-course 不同,取代码时按 release tag week7.0 克隆即可复现本章的代码状态。
第七周这一半的改动,本质是把检索从一个步骤提升成一个决策,代价是延迟不再可预测。图结构本身很薄——两个条件分支、几个职责单一的节点——难点不在 LangGraph 的 API,而在两个判断点的 prompt、回退的终止预算,以及答案出错时能不能从 reasoning_steps 里看出是谁的锅。下一章接 Telegram Bot,看这套会决策的系统怎么被搬到手机上可用的入口。