第 4 章:第三周:BM25 关键词检索,被低估的地基
第 4 章:第三周:BM25 关键词检索,被低估的地基
这一章解决什么问题:当大多数人把 RAG 等同于向量检索时,第三周要把被跳过的那一层补回来——一个可解释、可调参、可监控的 BM25 关键词检索系统。产物是 OpenSearch 2.19 上的 arxiv-papers 索引、支持多字段 boost 与 filter 的 Query DSL、一个同时提供简单与高级查询的搜索 API,以及用 precision / recall / relevance 衡量的评估口径。Week 1 的 Docker 基础设施与 Week 2 的 Airflow 管道在这一周第一次串起来:论文从 PostgreSQL 批量写进搜索引擎,再被查出来。
为什么关键词检索是 RAG 的地基
Week 3 的 README 开头就把问题摆出来:大多数 RAG 系统直接跳到 vector search,丢掉了最好的检索系统赖以工作的那一层,课程称之为 The 90% Problem。它给出的四条理由是:
- Exact Match Power:关键词在技术术语、paper ID、精确短语上表现最好,命中得直接
- Interpretable Results:你能确切知道一篇论文为什么被检索到
- Speed & Efficiency:BM25 计算开销小,不需要昂贵的 embedding 模型
- Production Reality:Elasticsearch、Algolia 以及企业级搜索产品都把关键词检索当地基
主 README 的表述更直接:不像那些一上来就讲 vector search 的教程,这条路线先掌握关键词检索的地基,再用向量去增强,走向 hybrid retrieval。第三周在课程表里的定义是 "Production BM25 keyword search with filtering and relevance scoring"——不是先用简单方案凑合,而是把排序、过滤、分页、高亮、评估这些通用检索能力先建齐,后面接向量时才有可对照的基线。
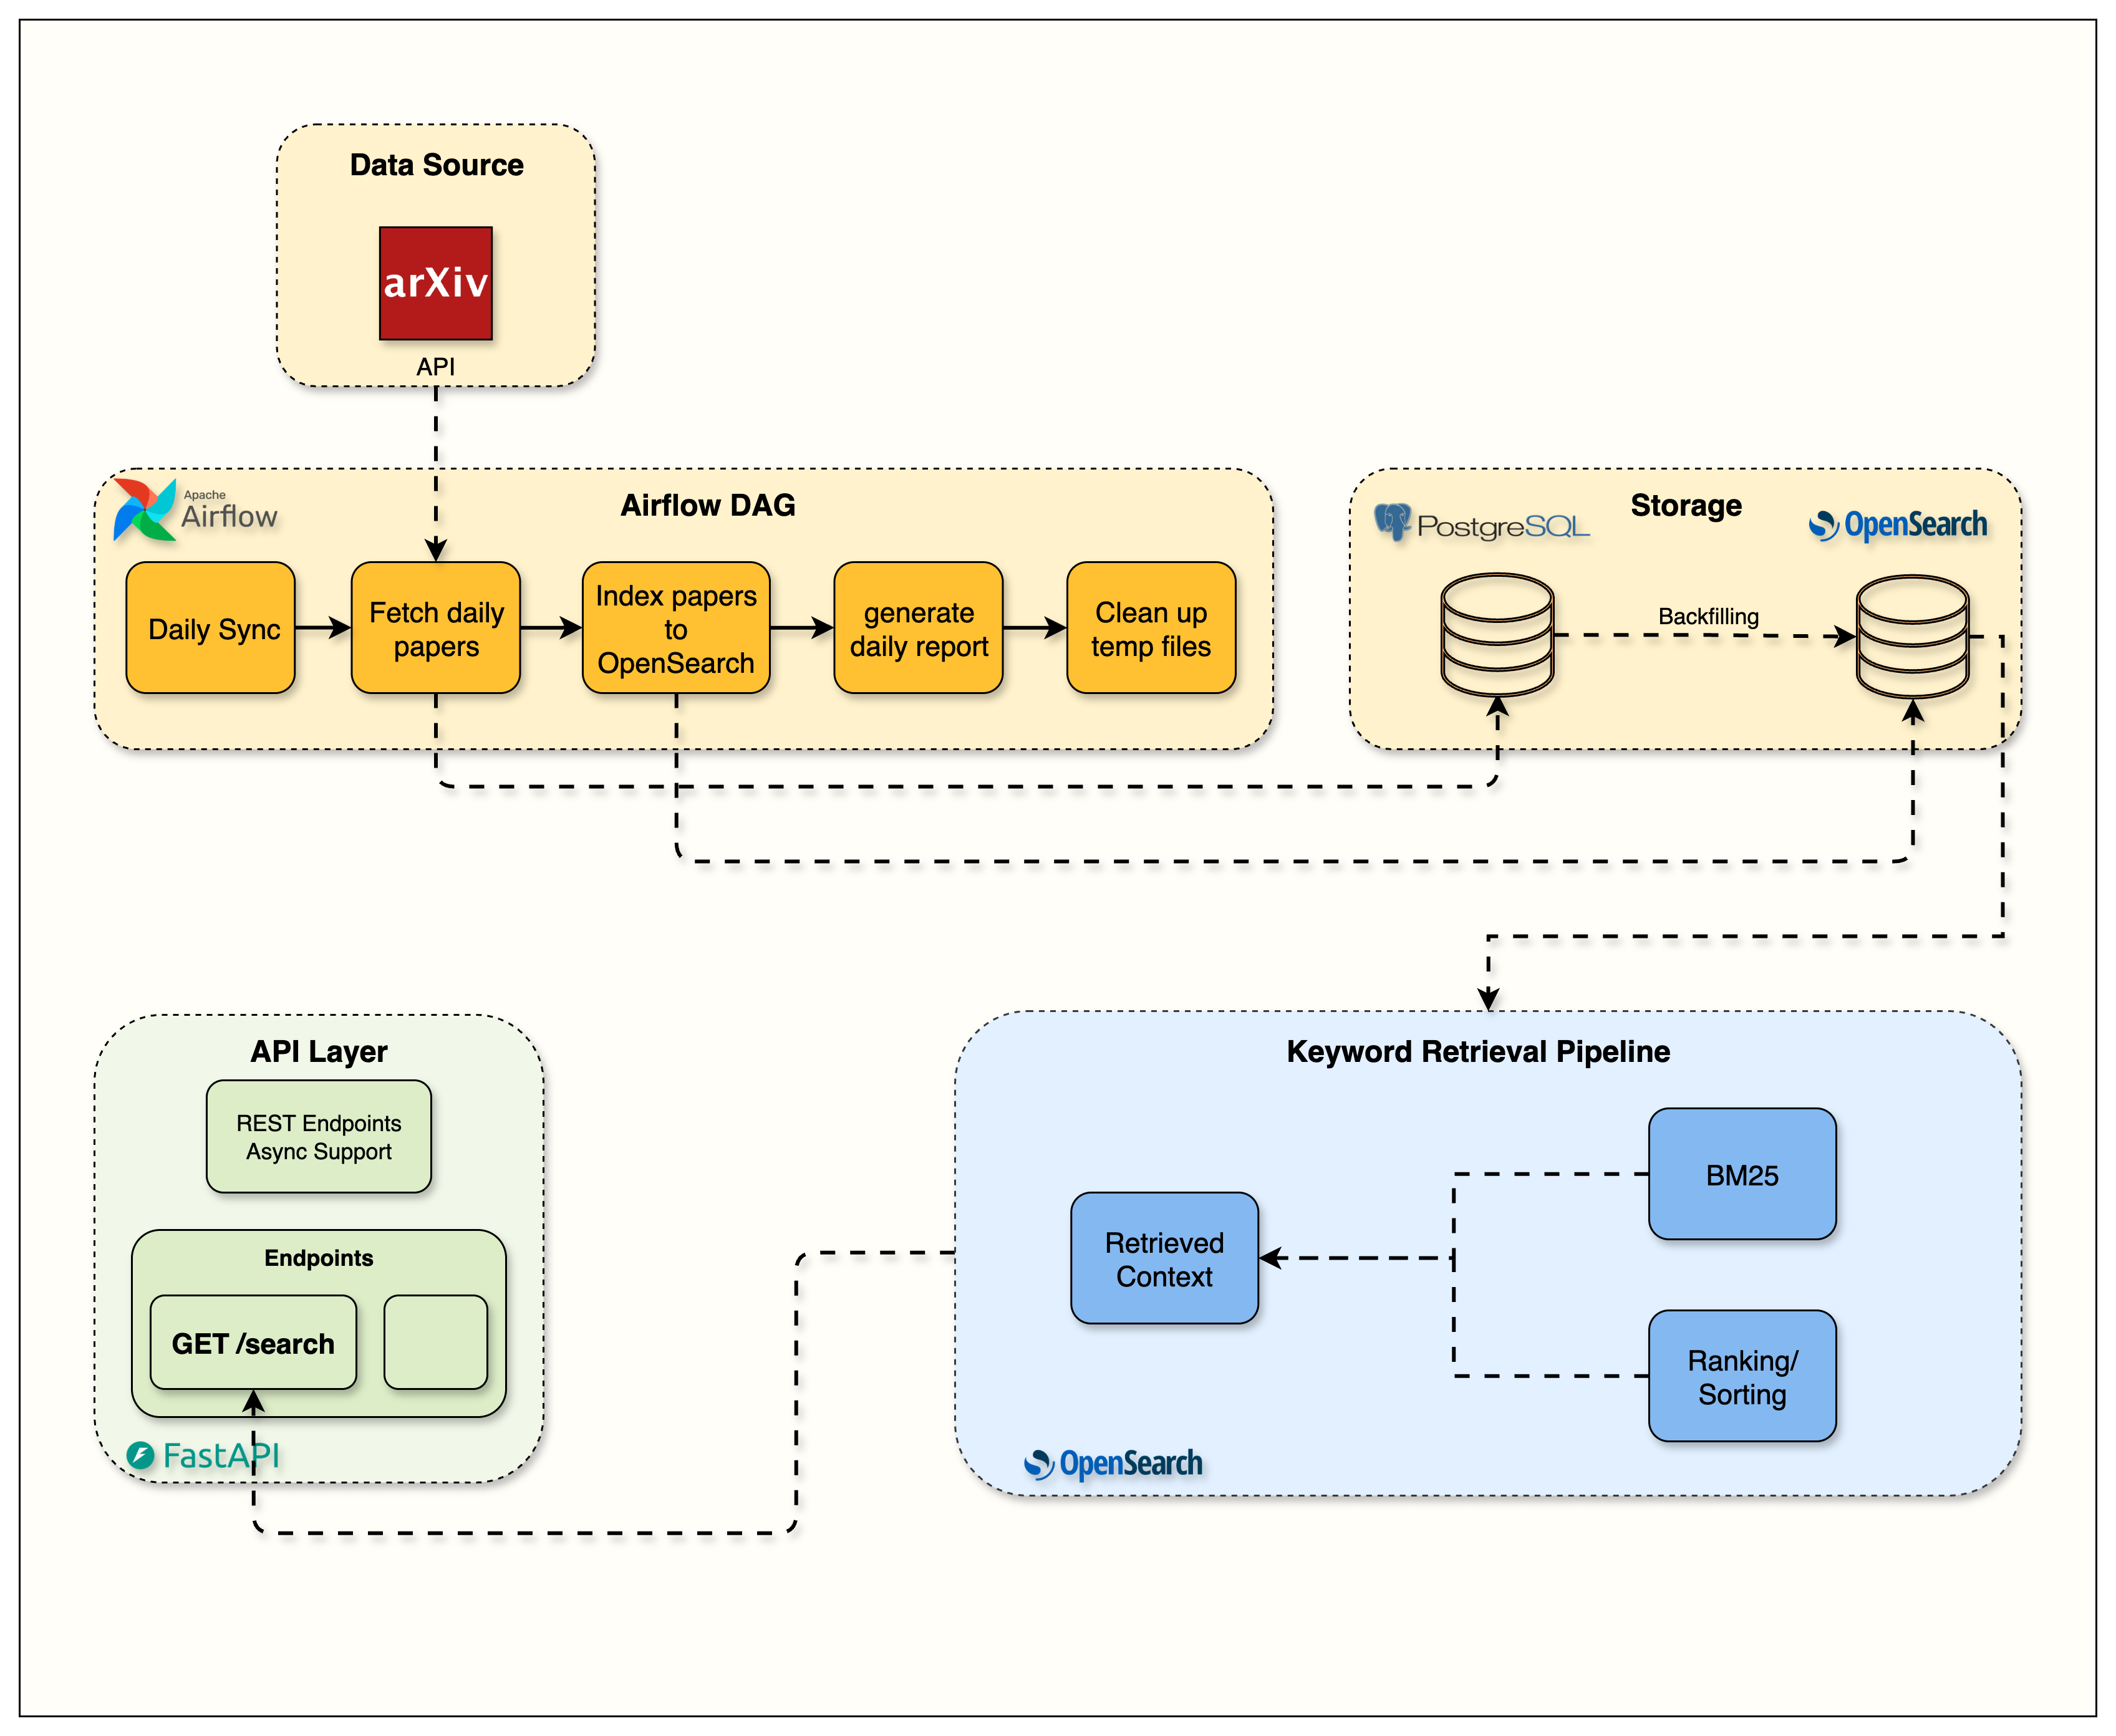
索引设计:mapping、analyzer 与分词
Week 3 的所有检索能力都压在索引定义上,这一步走歪,后面的 boost 和 filter 都是在错误的字段上做调优。Week 3 的做法是:
- JSON 化的索引配置,用配置文件而不是散落在代码里的字典来定义 analyzers
- English analyzer,针对英文论文做语言级处理,提升相关性
- 严格的 mapping,字段类型和分词方式在建索引时固定下来
- 面向学术论文的字段划分:
title、abstract、content,这也是多字段搜索和字段 boost 的前提
.env 里与本周直接相关的配置只有两条(默认值开箱即用):
cp .env.example .env

# OPENSEARCH__HOST=http://opensearch:9200
# OPENSEARCH__INDEX_NAME=arxiv-papers
索引 JSON 的结构大致如下,具体字段名与 analyzer 名称以 Week 3 notebook 中的配置为准:
{
  "settings": {
    "analysis": {
      "analyzer": {
        "default": { "type": "english" }
      }
    }
  },
  "mappings": {
    "properties": {
      "title":    { "type": "text", "analyzer": "english" },
      "abstract": { "type": "text", "analyzer": "english" },
      "content":  { "type": "text", "analyzer": "english" }
    }
  }
}
索引建好之后,notebook 里接着练索引管理:查索引健康、看索引统计、做文档级 CRUD。开发期它们看起来多余,出问题时是唯一能拿到证据的地方。
数据侧的动作是把论文数据从 PostgreSQL 迁移到 OpenSearch:bulk indexing 必须带错误处理和校验,写完立刻验证文档数对得上,而不是等搜索返回空结果再回头查。
BM25 打分:三个因子决定的排序
BM25 是业界标准的文本相关性排序算法,也是第三周唯一需要真正理解数学的那部分。它的打分可以拆成三件事:
score(D, Q) = Σ IDF(qi) * ( f(qi, D) * (k1 + 1) )
/ ( f(qi, D) + k1 * (1 - b + b * |D| / avgdl) )- 词频(term frequency):查询词在文档里出现越多分越高,但不是线性增长。分母里的
f(qi, D)和k1让增长饱和——一个词从 1 次到 2 次的收益,远大于从 20 次到 21 次 - 逆文档频率(IDF):越罕见的词权重越高。这解释了为什么两字母查询
AI、ML、NN、CV需要特殊对待——它们在语料里太常见,IDF 被压低,不容易区分文档 - 字段长度归一化(field length normalization):
|D| / avgdl加上参数b,让长文档不因为"词多"而白占便宜。一篇 10 页论文的 abstract 和一篇 2 页论文的 abstract 长度不同,长度归一化会把这点抹平
k1 控制词频饱和速度,b 控制长度归一化强度,OpenSearch 有默认值。课程这一周不做参数调优:评估集建立之前调参是盲调,重点是把打分口径和可解释性立住。
字段权重是显式配置的,不靠模型学习:title 3x boost、abstract 2x boost、content 1x boost。这个比例表达的是检索意图:标题里出现某个术语,比正文提到一次更能说明这篇论文讲的就是这个。
可解释性正是 BM25 在 Agentic RAG 里的价值:向量检索只给一个距离值,BM25 能告诉你哪个词、在哪个字段、贡献了多少分——Agent 判断"检索结果够不够好"时,这是可用的信号。
Query DSL:把检索意图写进查询
OpenSearch 的查询用 Query DSL(JSON)表达。Week 3 用到的能力覆盖了绝大多数生产场景:
{
  "query": {
    "bool": {
      "must": {
        "multi_match": {
          "query": "retrieval augmented generation",
          "fields": ["title^3", "abstract^2", "content"]
        }
      },
      "filter": [
        { "term":  { "": "cs.CL" } },
        { "range": { "": { "gte": "2024-01-01" } } }
      ]
    }
  },
  "highlight": {
    "fields": { "title": {}, "abstract": {} }
  },
  "from": 0,
  "size": 10
} - 多字段 + boost:
fields里的^3、^2就是字段权重,写法和打分行为一一对应 - filter 与 must 的区别:
filter里的条件只做筛选,不参与打分。category 过滤和 date range 属于"必须满足但不加分"的条件,放进filter既语义正确,也让 OpenSearch 有机会跳过打分开销 - highlight:结果里带回带 HTML markup 的高亮片段——用户能立刻看出命中的是哪个词
- from / size:分页。大结果集必须分页,
size不能当成"多取一点更保险" - fuzzy matching:容忍拼写错误和形态变化,配置要比精确匹配克制,否则召回一堆噪声
两字母查询(AI、ML、NN、CV)在 Week 3 里被单独列为测试项。短查询最难:分词后信息量极低,IDF 又测不出区分度,容易被长文档用词频淹没。把这类查询跑通,说明 analyzer、字段权重和查询结构是自洽的。
搜索 API:GET 查简单,POST 查复杂
服务层的实现落在两个位置:
src/
├── routers/
│   └── search.py        # Search API endpoints with BM25 scoring
└── services/
    └── opensearch/      # Professional search service implementation
notebooks/
└── week3/
    └── week3_opensearch.ipynb
端点的划分按查询复杂度来,这是这一周值得记住的设计选择:
| Endpoint | Method | 用途 |
|---|---|---|
/search |
GET | 简单查询,参数可直接放进 URL |
/search |
POST | 高级查询,完整的 Query DSL 走 request body |
/api/v1/search |
POST | 主 README 端点表中的 Week 3 条目:BM25 keyword search |
/api/v1/health |
GET | 服务健康检查 |
服务创建用 Factory Pattern 统一,生命周期交给 FastAPI 的 lifespan 管理,搜索请求通过 dependency injection 拿到 OpenSearch 客户端。查询本身用 Query Builder Pattern 组装——把"标题加权、过滤分类、开高亮、分页"拆成可组合的构建步骤,而不是在路由里手拼 JSON。响应体包含分页信息、元数据和高亮片段;错误处理要求 graceful degradation,OpenSearch 不可用时返回明确的失败信号,而不是抛一个 500 了事。
# 服务起来之后先确认链路是通的
curl http://localhost:8000/api/v1/health
相关性评估与 OpenSearch Dashboards 实操
检索系统没有评估就没有迭代方向。Week 3 明确的 quality metrics 是 precision、recall 和 relevance scoring。落到操作上:
- 准备一批固定查询(两字母查询
AI/ML/NN/CV是必测的一组),逐条看 top-N 结果 - 人工标注返回结果里哪些真的相关,算出 precision;对着已知的相关论文集合,看漏掉了哪些,算出 recall
- 对排序本身做 relevance scoring:不只是"有没有返回",而是"相关的是否排在前面"
- 做性能基准测试并记录响应时间。课程 README 给出的口径是 sub-100ms search,验收标准同样写 sub-100ms——这是课程设定的目标,不是任何部署环境都能自动达到的
- 期望产出是一套能查的检索系统,README 的说法是 28+ indexed papers
主 README 的截图说明写明:OpenSearch Dashboards 展示的是带 BM25 relevance scoring 的搜索结果和排序。Dashboards 在 http://localhost:5601,除看结果外还能看索引健康、索引统计和服务可用性。开发期用它调试比反复改代码跑测试快:改一次 Query DSL,立刻能看到打分和排序怎么变。
生产环境中的检索模式
第三周里那些看起来"过度设计"的部分,是生产环境与玩具项目的分界线:
- Factory Pattern + dependency injection:服务创建和生命周期管理集中在一处,测试时可以替换实现
- Query Builder Pattern:查询构造与路由解耦,复杂查询不会散落成一堆字符串拼接
- Graceful degradation:依赖不可用时的降级路径是设计的一部分
- Health monitoring:cluster status、index statistics、service availability 三类信号都有对应入口
- 水平扩展的架构前提:搜索服务设计成无状态、可横向扩展
数据管道这一周也要改:Airflow DAG 的任务序列变成 setup → fetch → opensearch → report → cleanup,原来占位的索引操作换成真实的 OpenSearch 写入,日报里加入搜索统计和健康指标。PDF 处理有明确上限,超过 20MB 或超过 30 页的论文被优雅跳过,防止内存被打爆。端到端验收链路是 arXiv API → PostgreSQL → OpenSearch → Search API,跑通才算这周结束。
最后是取舍。BM25 快、便宜、可解释,短板同样明确:用户换个说法,或者论文用的是同义词,关键词检索就找不到。这不是靠调 k1、b 或加 boost 能解决的,它需要语义层。Week 4 的 intelligent chunking 和 hybrid retrieval 正是冲着这一点去的——先有这条 BM25 基线,才能说清向量检索额外带来了多少召回。
参考链接
- 课程仓库:jamwithai/production-agentic-rag-course
- 课程主 README:README.md
- Week 3 notebook:notebooks/week3/week3_opensearch.ipynb
- Week 3 代码 release:week3.0
- 配套博客:The Search Foundation Every RAG System Needs
- 环境变量模板:.env.example
本地跑通这一周的路径很直接:cp .env.example .env、uv sync、docker compose up --build -d,再用 uv run jupyter notebook notebooks/week3/week3_opensearch.ipynb 走一遍建索引、写数据、查结果、看 Dashboards。等你能对 AI 或 CV 这种两字母查询解释清楚"为什么这篇排第一",这一层地基就算打完了。