第 6 章:第五周:接上本地 LLM,把检索变成对话
第 6 章:第五周:接上本地 LLM,把检索变成对话
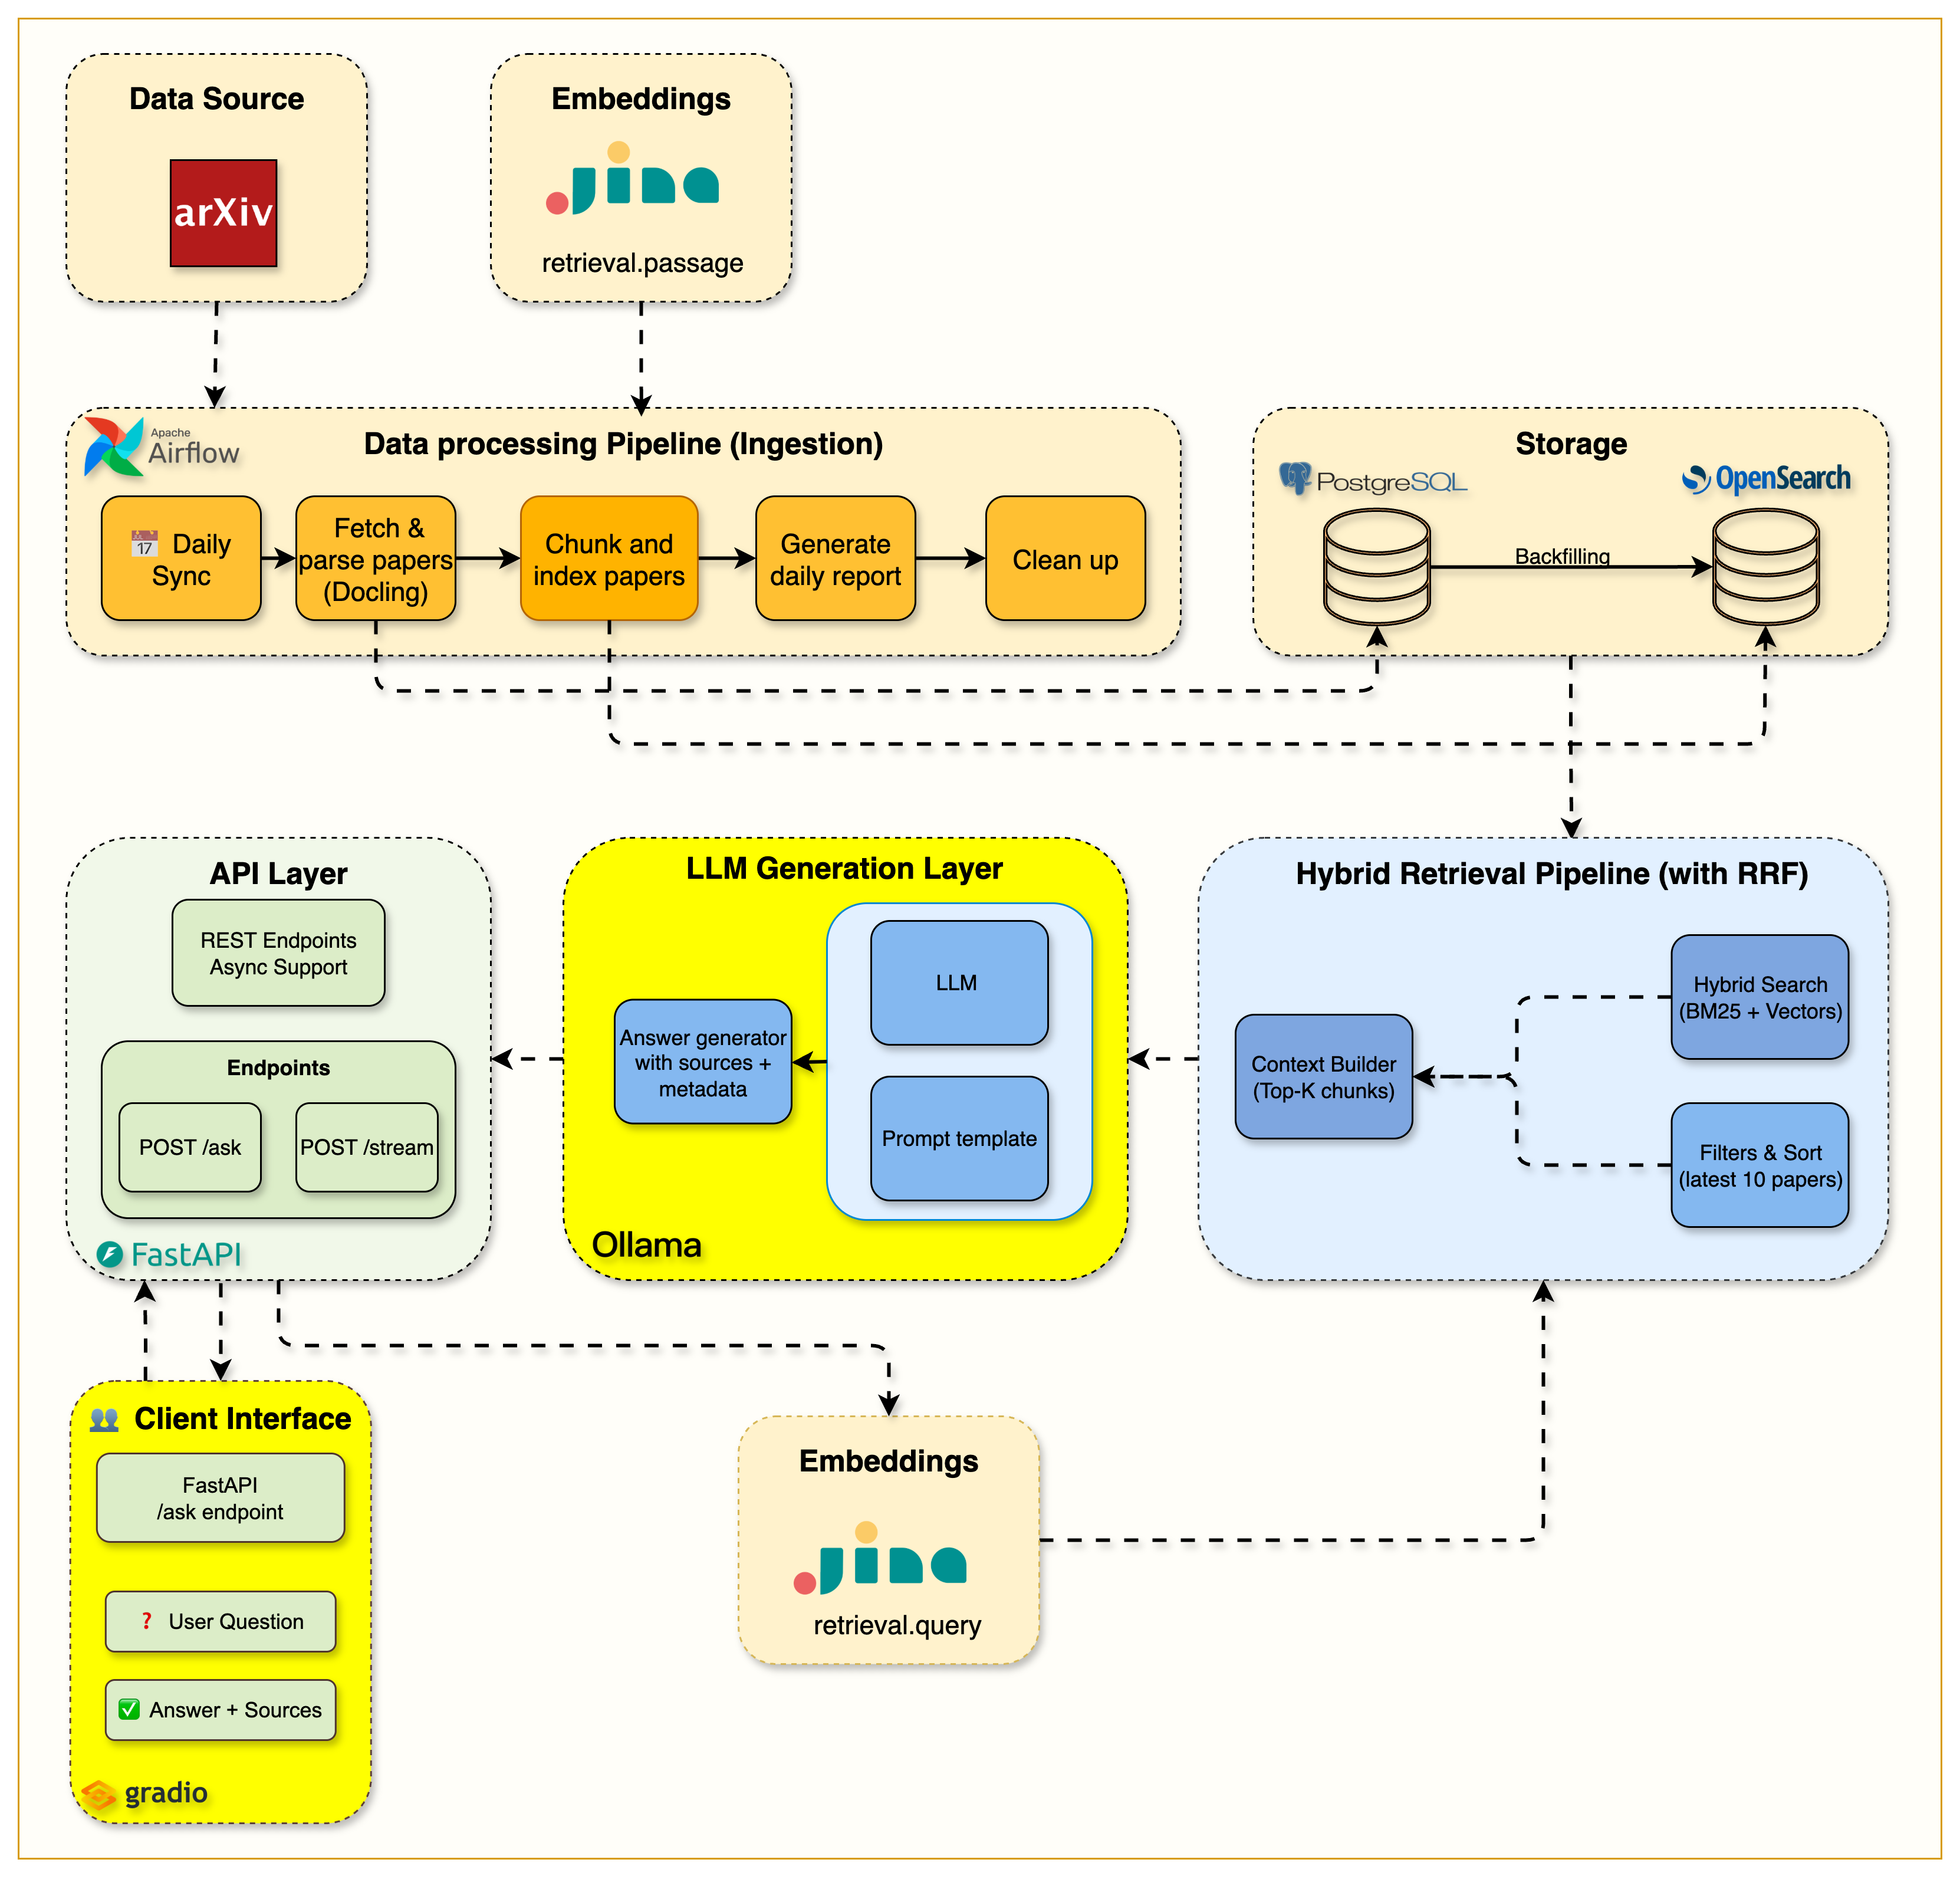
第 4 周结束时,/api/v1/hybrid-search/ 已经能返回排好序的 chunk,但用户拿到的是一个 JSON 数组——他还得自己去读那些论文片段。第 5 周要补上最后一层:把检索结果组装进 prompt,交给本机跑的 Ollama 生成一段人能读的答案。同时要解决两个工程问题:15-20 秒的等待怎么变成可以忍受的交互,以及同一套检索逻辑怎么同时服务批处理脚本和聊天界面。
把 LLM 留在本机:Ollama 的定位与代价
Ollama 在第 1 周就作为基础设施的一部分起在 Docker Compose 里,容器内地址是 http://ollama:11434,到第 5 周才真正被业务代码调用。默认模型是 llama3.2:1b,由 OLLAMA__DEFAULT_MODEL 配置。
选本地推理的直接收益是数据不出本机:论文正文、chunk、用户查询全部在 Compose 网络内部流转,不经过任何第三方推理 API,没有请求体被记录在别人日志里的可能。课程 README 的成本结构也写明 Local Development 是 $0,这正是全本地栈的结果。
代价同样要说清楚。1b 量级的模型在长上下文和需要多跳推理的问题上明显弱于云端大模型;15-20 秒的完整响应,在云端 API 上通常只要几百毫秒到几秒。课程选它的理由是可复现——不申请任何 LLM key 就能把整条链路跑通,Week 4 起需要的 JINA_API_KEY 是用来做 Embedding 的,跟生成无关。如果你要换成更大的本地模型,OLLAMA__DEFAULT_MODEL 改一行即可,但性能表里那些数字就不再成立了。
系统提示词瘦身:80% 的缩减从哪来
系统提示词放在 src/services/ollama/prompts/rag_system.txt,README 对它的一句话描述是 Optimized for academic papers。Week 5 的性能优化里占大头的一项,是把检索结果中冗余的 metadata 从 prompt 里删掉——chunk 带着一堆前端才需要的字段进上下文,纯属浪费 token。
这里必须交代口径。week5 README 的 Overview 写的是 "6x faster performance (120s → 15-20s)",学习目标里写的是 "80% prompt reduction, 6x speed improvement"。这是课程作者在自己那套 Docker Compose 环境、用默认模型测出来的对比,不是跨硬件、跨模型的 benchmark;换机器、换模型、换 top_k,比例都会变。把它当优化方向读,不要当承诺读。
跟它并列的其他几条优化是:300 词的回答上限、共享代码架构(DRY)、以及自动的 source 去重。300 词上限不只是风格约束,它直接压住输出 token 数,而生成时长很大一部分就花在输出上。
双端点:/api/v1/ask 与 /api/v1/stream
Week 5 的 API 只有两个端点,都定义在 src/routers/ask.py:
| Endpoint | Purpose | 时间 | Use Case |
|---|---|---|---|
/api/v1/ask |
完整响应,带 metadata | 15-20 seconds | Batch processing、API integrations |
/api/v1/stream |
逐 token 实时生成 | Time to First Token 2-3 seconds | Interactive UIs、更好的 UX |
为什么不给 /ask 加一个 stream=true 参数?因为流式响应一旦发出第一个字节,HTTP 状态码就已经确定了,之后出错只能在事件体里带错误信息;而非流式端点可以老老实实返回 500 和结构化的 error。两边的客户端也不同:批处理脚本要的是完整 JSON,浏览器要的是能边生成边渲染。拆成两个端点各自语义干净,代价是看起来像重复代码——README 特意强调用 shared code architecture 消掉了这份重复,检索与 prompt 组装只有一份实现,两个端点只是消费方式不同。
SSE 与「首 token」这个指标
完整答案要 15-20 秒,这个数字对任何一种交互界面都是灾难。/api/v1/stream 用 Server-Sent Events 把回答按 token 推给客户端,Time to First Token 降到 2-3 秒,用户在两三秒内就看到内容开始长出来,感知延迟和总时长脱钩了。
验证流式行为时,curl 必须加 --no-buffer,否则 curl 会替你缓冲,看起来跟非流式一模一样:
curl -X POST "http://localhost:8000/api/v1/stream" \
  -H "Content-Type: application/json" \
  -d '{"query": "Explain attention mechanism", "top_k": 2}' \
  --no-buffer
Week 5 README 的排障表里,/stream 返回 404 是最常见的一条,原因是容器里跑的还是旧镜像,改完代码没有重建:
docker compose build api && docker compose restart api请求格式与性能表现
两个端点共用同一个请求体结构,top_k 取值范围 1-10:
{
    "query": "Your question",
    "top_k": 3,              // Chunks to retrieve (1-10)
    "use_hybrid": true,      // BM25 + vector search
    "model": "llama3.2:1b",  // LLM model
    "categories": ["cs.AI"]  // Optional filter
}query:问题原文,同时参与 BM25 和 embedding 两条检索路径。top_k:检索回来的 chunk 数。它既是质量旋钮,也是延迟旋钮。use_hybrid:true走 BM25 + vector 的 Hybrid Search,false只走 BM25。model:指定 Ollama 模型,默认llama3.2:1b。categories:可选,按 arXiv 分类过滤,例如cs.AI。
README 给出的三种配置对比:
| Configuration | Response Time | Use Case |
|---|---|---|
top_k=1, BM25 |
~2.4s | Quick answers |
top_k=3, Hybrid |
~15-20s | Balanced quality |
top_k=5, Hybrid |
~25-30s | Comprehensive |
这张表值得逐行读。top_k=1 配 BM25 只要 ~2.4 秒,因为它既没有 embedding 调用、也没有 RRF 融合,prompt 里只有一段上下文。切到 hybrid 并加到 3 个 chunk,时间直接跳到 15-20 秒——多出来的部分主要不是检索,而是更长的 prompt 让本地 LLM 的 prefill 和生成都变慢。再加到 5 个 chunk,是 ~25-30 秒。延迟基本随 prompt 长度上涨,而 prompt 长度约等于 top_k 乘以单个 chunk 的长度。所以 top_k 取多少不是拍脑袋定的,先问清楚这个场景能忍多久比较实际。
Gradio 界面与参数控制
命令行调参终究不直观,src/gradio_app.py 提供了一个网页界面,gradio_launcher.py 是配套的启动脚本。Gradio 默认端口 7860 在这里被换成了 7861,README 排障表专门为此写了一条 "No Gradio → Port changed to 7861":
uv run python gradio_launcher.py
# Open http://localhost:7861
界面本身支持 streaming,所以能直接看到 /api/v1/stream 的逐 token 效果,而不是只看到最终答案。参数控制对应的就是请求体里那几个字段——top_k、use_hybrid、model、categories 都能在页面上改,这也是它作为调试工具的主要价值:同一个问题换 top_k 和检索模式各跑一遍,延迟和答案质量的差别立刻可感。给非工程同事演示时它同样够用,但它没有鉴权、没有并发控制,别把它当生产前端。
Week 5 的范围到这里为止:对话记忆不在里面,README 把它列在 Next Steps 里(Add conversation memory, feedback loops)。也就是说,这个系统能回答一次问题,但还不记得上一轮问过什么——多轮和 Agent 化的部分留给后面。
参考链接
- 课程仓库:jamwithai/production-agentic-rag-course
- Week 5 notebook:notebooks/week5/week5_complete_rag_system.ipynb
- Week 5 说明:notebooks/week5/README.md
- RAG 端点:src/routers/ask.py
- Ollama 客户端:src/services/ollama/client.py
- 系统提示词:src/services/ollama/prompts/rag_system.txt
- Gradio 界面:src/gradio_app.py 与 gradio_launcher.py
- 配套博客:The Complete RAG System
- 代码 release:week5.0