第 3 章:第二周:arXiv 论文摄取管线与 PDF 解析
第 3 章:第二周:arXiv 论文摄取管线与 PDF 解析
Week 1 留下的是一套能跑但空转的基础设施:FastAPI、PostgreSQL 16、OpenSearch 2.19、Apache Airflow、Ollama 各自占了端口,curl http://localhost:8000/api/v1/health 能通,可数据库里没有一张论文记录,搜索索引里没有一个文档,LLM 没有语料可读。这一章处理 Week 2 的问题:把 arXiv 的 CS.AI 论文抓下来、下载 PDF、解析成结构化内容、以幂等方式写进 PostgreSQL,再交给 Airflow 每天自动跑一遍。课程 README 给 Week 2 的定位是 "Automated data pipeline fetching and parsing academic papers from arXiv",这一周不碰 Embedding,也不碰检索,只回答一个问题——数据从哪来、怎么进库。
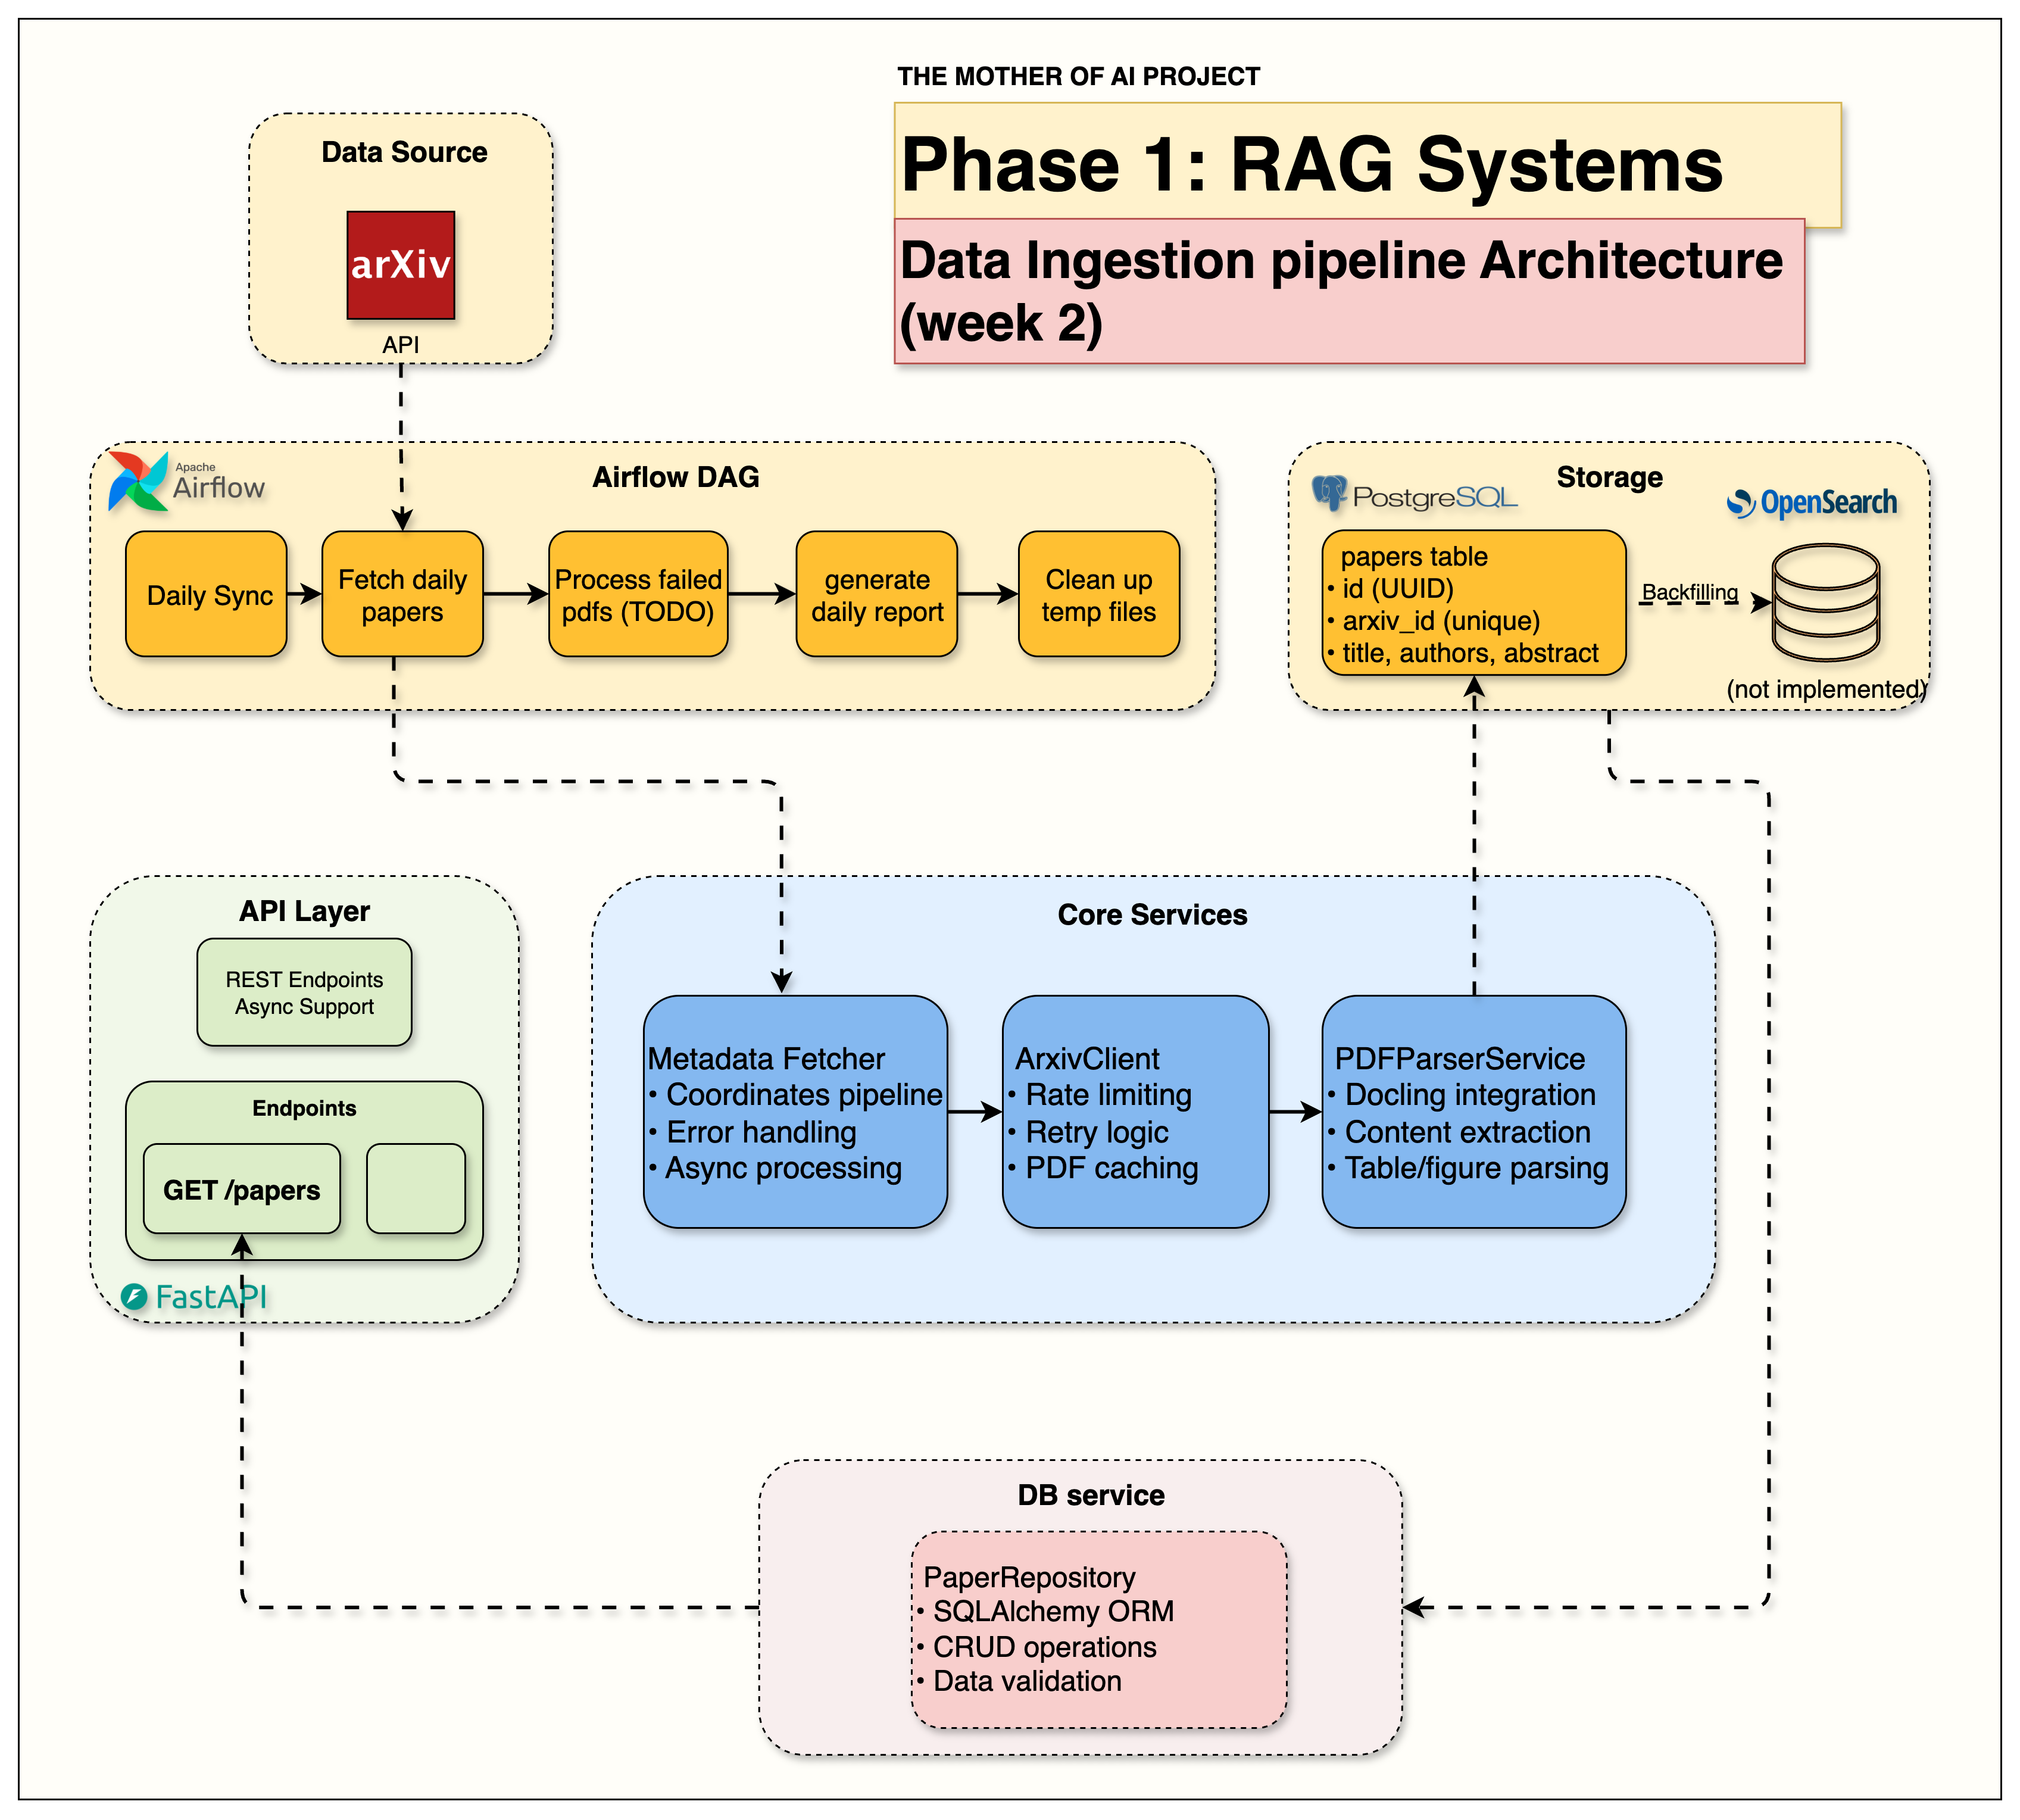
MetadataFetcher:编排者,不是下载器
Week 2 的 README 在数据管线组件表里给 MetadataFetcher 标了一个 🎯,说明它是 "Main orchestrator coordinating the entire pipeline"。这句话界定了它的职责边界:它自己不实现 HTTP 请求,也不实现 PDF 解析,而是按顺序协调其余四层。
| 组件 | 职责 |
|---|---|
| MetadataFetcher | 🎯 Main orchestrator coordinating the entire pipeline |
| ArxivClient | Rate-limited fetching with retry logic(3-second delays) |
| PDFParserService | Scientific PDF parsing with structured content extraction |
| PaperRepository | PostgreSQL integration with upsert operations |
| Airflow DAGs | Automated daily ingestion workflows |
多抽一层编排者是有原因的。限流策略会变(arXiv 的 API etiquette 变了,改 ArxivClient 就行),解析器会换(Docling 换成别的实现,只动 PDFParserService),落库方式会变(upsert 的键换了,只动 PaperRepository)。而且 Airflow 的 airflow/dags/arxiv_ingestion/ 目录里放的就是生产管线任务,airflow README 把它描述为 "Production pipeline tasks with async processing"(README 里写的是单个 tasks.py,但仓库当前实际拆成了 common.py、fetching.py、indexing.py、reporting.py、setup.py 几个模块——以仓库代码为准)。它复用同一批 service——notebook 里手工跑的链路和 DAG 里自动跑的链路必须是同一条,否则你在 notebook 里调通的参数,到了生产调度就未必成立。
ArxivClient:限流、重试与查询构造
ArxivClient 是整条管线里唯一接触外部服务的组件,所以它的设计重心不是吞吐,而是合规与容错。Week 2 README 写得很明确:ArxivClient 是 "Rate-limited fetching with retry logic (3-second delays)",也就是每次请求之间固定留 3 秒。这个数字直接决定了系统上限,后面性能一节会算这笔账。
客户端要做的三件事:
- 日期过滤(date-based filtering)——只取目标时间窗内的论文,DAG 里默认取 "papers from previous day"。
- 分类过滤(category filter)——notebook 里做的是 CS.AI 类目检索测试,带 "proper API etiquette"。
- 结果数量限制(result limiting)——DAG 默认 10 papers,避免一次抓取把后续解析环节压垮。
重试与错误处理是配套的:单次请求失败要能重试,重试仍失败要能记录并继续,而不是让整个任务挂掉。Week 2 README 在管线图里把这一层标注为 Retry Logic → Error Handling → 3s Rate Limit,三个词并列,说明它们是一个整体策略——重试必须发生在限流的约束之内,不能靠并发绕开 3 秒间隔。
PDFParserService:用 Docling 解析,并接受失败
PDF 这一层最容易产生错误的期待。PDF 解析不是确定性操作,Week 2 README 明确写了:"Not all PDFs parse successfully (expected behavior)",而且给了量化的正常范围——PDF parsing 成功率 80-90% 属于正常,"Docling works best with standard academic paper formats"。课程的口径是成功率的两个数:paper fetching 95%+,PDF parsing 80-90%。
所以 PDFParserService 的设计目标不是"让每篇都成功",而是"让失败的论文不拖垮整批"。它包含四个动作,与 README 的管线图列出的 Caching → Validation → Structure Extraction → Metadata 一一对应:
- 下载并缓存 PDF 文件——"PDF files cached locally to avoid re-downloading",重复运行 DAG 时不会二次消耗带宽。
- 校验(Validation / Size Checks)——抓到的文件要先判断是不是一个像样的 PDF,再送进解析器。
- Docling 结构化抽取(Structure Extraction)——从科学 PDF 中抽出结构化内容,而不是一坨纯文本。
- 兜底(fallback mechanisms)——"Handle parsing failures gracefully with fallback mechanisms",解析失败时降级处理,至少保住元数据。
Airflow DAG arxiv_paper_ingestion:日更与生产特性
Airflow 目录里现在有两个 DAG:hello_world_dag.py 是 Week 1 的健康检查,arxiv_paper_ingestion.py 是 Week 2 的主生产 DAG,负责 "automated arXiv paper fetching and processing"。
它的任务序列是七个阶段:
- Environment Setup:校验依赖服务、初始化缓存。
- Daily Paper Fetch:抓取前一天的论文,默认 10 篇。
- PDF Processing:下载并用 Docling 解析。
- Failed PDF Retry:单独处理解析失败的论文。
- Database Storage:把完整论文数据连同解析内容落库。
- OpenSearch Placeholders:为 Week 3 及之后的检索索引预留占位。
- Daily Report:生成处理统计。
这七步里有三处是典型的"生产特性",不是教学装饰:
- 失败重试被单独建模成一个任务(Failed PDF Retry),而不是塞在解析任务的内部循环里。这样在 Airflow UI 上你能一眼看到"这次有几篇解析失败、重试后救回来几篇"。
- 幂等靠 PaperRepository 的 upsert 保证。"Implement upsert logic to avoid duplicates" 是 Week 2 的实现要求之一。日更 DAG 每天跑,昨天的论文和今天的窗口必然有交叠;DAG 手工重跑也必须安全。upsert 把这两件事一次性解决,而不是靠时间去重。
- 日志与日报体现在 Daily Report 任务上,README 把它写作 "Generate comprehensive processing statistics",配合 Airflow 自带的 task logs,构成最低成本的监控。
Airflow 容器本身的配置:
AIRFLOW__DATABASE__SQL_ALCHEMY_CONN=postgresql+psycopg2://rag_user:rag_password@postgres:5432/rag_db
AIRFLOW__CORE__EXECUTOR=LocalExecutor
POSTGRES_DATABASE_URL=postgresql+psycopg2://rag_user:rag_password@postgres:5432/rag_db
PYTHONPATH=/opt/airflow/src
注意 LocalExecutor 与共享 PostgreSQL 这个组合:Airflow 的元数据库和业务库是同一个 rag_db,PYTHONPATH 指向容器内的 src,所以 DAG 里的 task 能直接 import 应用的 service 层。目录结构如下:
airflow/
├── README.md                           # This file
├── Dockerfile                          # Custom Airflow container with dependencies
├── requirements-airflow.txt            # Python dependencies for DAGs
└── dags/
    ├── hello_world_dag.py             # Week 1 health check DAG
    ├── arxiv_paper_ingestion.py       # Week 2 production ingestion DAG
    └── arxiv_ingestion/
        └── tasks.py                   # Production pipeline tasks with async processing
有一个版本口径值得留意:主 README 的技术栈表写的是 Apache Airflow 3.0,而 airflow/README.md 的容器说明写的是 Python 3.12 与 Apache Airflow 2.10.3。两处不一致,动手时以你实际拉起的镜像为准,别照着一个数字去猜另一个。Web 界面在 http://localhost:8080,用户名密码在容器初始化时自动生成,位置是 airflow/simple_auth_manager_passwords.json.generated。
从 API 到 PostgreSQL:一次完整的数据流
把上面几节拼起来,README 给的管线图是这样的(原文照录):
arXiv Search Query → Rate Limited API Calls → PDF Downloads → Docling Parsing → Database Storage
        ↓                    ↓                    ↓              ↓               ↓
   Date Filtering    →  Retry Logic       →   Caching      → Structure    →  Upsert Logic
   Category Filter   →  Error Handling    →   Validation   → Extraction   →  Transactions
   Result Limiting   →  3s Rate Limit     →   Size Checks  → Metadata     →  Relationships
三层含义值得拆开看。第一行是五个阶段,第二三行是每个阶段里真正干活的东西。抓取阶段承担了三个约束(日期、类目、数量)和两个韧性机制(重试、错误处理),解析阶段承担缓存、校验与结构抽取,落库阶段承担 upsert、事务和关系(Relationships)——PostgreSQL 里存的不只是论文元数据,还有解析出的内容以及它们之间的关联。
落库之后的数据可以通过 Week 2 就已有的两个端点验证:
| Endpoint | Method | Description | Week |
|---|---|---|---|
/api/v1/papers |
GET | List stored papers | Week 2 |
/api/v1/papers/{id} |
GET | Get specific paper | Week 2 |
注意 Week 2 的 DAG 里 OpenSearch 只是 Placeholders。这不是偷懒,是刻意的章节切分:数据先落 PostgreSQL,Week 3 才谈 OpenSearch index 的 mapping 与 BM25 检索。
性能特征:数字的出处与瓶颈在哪
下面这些数字全部来自课程 Week 2 README 的 "Performance Characteristics" 一节,口径是课程给出的系统能力说明,不是压测报告:
| 环节 | 口径 |
|---|---|
| arXiv API | ~20 papers/minute(respecting 3-second rate limits) |
| PDF Processing | 2-5 seconds per paper(depends on PDF complexity) |
| Database Storage | ~100 papers/second(batch operations) |
| Error Handling | Graceful continuation despite individual failures |
| Success Rates | 95%+ for paper fetching,80-90% for PDF parsing |
瓶颈非常清楚。抓取端 3 秒一次请求,一分钟约 20 篇;解析端每篇 2-5 秒;而数据库批量写入约 100 篇/秒。落库快了三个数量级,抓取被 API etiquette 锁死,解析是第二道闸门。
DAG 的并发配置正是围绕这个事实做的取舍:"Concurrent Processing: 5 parallel downloads, 1 parsing operation (laptop-optimized)"。下载是 I/O 密集,5 路并发能填满等待时间;解析是 CPU 与内存密集,课程把它压到 1 路,理由是 laptop-optimized——Docling 解析科学 PDF 时内存占用不低,同时开多个解析进程在 8GB 内存的开发机(Week 1 的前置要求是 8GB+ RAM 与 20GB+ 磁盘)上大概率会触发 OOM。README 的 Week 3+ 路线图里把 "Scale Optimization: Higher concurrency for production workloads" 列为待办,也侧面说明 1 路是开发机上的有意妥协,而非终态。
README 给的时间估算:fresh container build 10-15 分钟,notebook 完成 45-60 分钟,pipeline 测试 30-45 分钟,合计 1.5-2 小时。容器构建最耗时,原因见下一节。
容器重建与跨平台 Docker 配置
Week 2 有一个容易踩的坑,README 单独用 "Fresh Container Build Required" 标了出来:必须重建容器。
# Shutdown and rebuild (REQUIRED for Week 2)
docker compose down
docker compose up --build

# This ensures:
# - New Python dependencies (docling, arxiv client)
# - Updated Airflow DAGs
# - Fresh service configurations
docker compose restart 不够。Week 1 的镜像里没有 docling 和 arxiv client,只重启不重建,DAG 里的 import 会直接失败;Airflow 的 DAG 文件也只在镜像构建时进入容器的 dags 目录。彻底重来的命令是 docker compose down --volumes && docker compose up --build -d,注意 --volumes 会连数据一起清掉。另外 README 提醒服务起不来时先等 2-3 分钟再判断,端口冲突优先查 8000、8080、5432、9200 这四个。
Airflow 容器的跨平台兼容性由四处配置保证(README 声称覆盖 macOS、Linux、WSL 与 Ubuntu):
- User Configuration:以
airflow用户(50000:0)运行,避开宿主机挂载目录的权限问题——这是 macOS 与 Linux 之间最常见的分歧点。 - Volume Management:logs 用 named volumes 而不是 bind mount,避免 bind mount 在不同宿主机文件系统上的行为差异。
- Database Integration:连接共享的 PostgreSQL 实例,而不是容器内自带的 SQLite。
- Service Dependencies:自动初始化与健康检查,等到 PostgreSQL 可用之后再启动。
镜像内还预装了 Docling 需要的系统依赖:Tesseract OCR 与 Poppler utilities,以及 PostgreSQL 的 psycopg2 驱动。换句话说,PDF 解析能力是打包在 Airflow 容器里的,不是靠宿主机环境凑出来的——这也是 fresh build 需要 10-15 分钟的直接原因。
参考链接
- 课程仓库:https://github.com/jamwithai/production-agentic-rag-course
- 主 README(Week 2 章节与整体路线图):https://github.com/jamwithai/production-agentic-rag-course/blob/main/README.md
- Week 2 notebook:https://github.com/jamwithai/production-agentic-rag-course/blob/main/notebooks/week2/week2_arxiv_integration.ipynb
- Airflow 配置说明:https://github.com/jamwithai/production-agentic-rag-course/blob/main/airflow/README.md
- 生产 DAG:https://github.com/jamwithai/production-agentic-rag-course/blob/main/airflow/dags/arxiv_paper_ingestion.py
- DAG 任务实现目录(README 里写的是单个
tasks.py,仓库实际是多个模块):https://github.com/jamwithai/production-agentic-rag-course/tree/main/airflow/dags/arxiv_ingestion - Week 2 release tag:https://github.com/jamwithai/arxiv-paper-curator/releases/tag/week2.0
- 配套博客(主 README 中的 Week 2 条目,Building Data Ingestion Pipelines for RAG):https://jamwithai.substack.com/p/bringing-your-rag-system-to-life
- 配套博客(Week 2 README 中列出的 Additional Resources):https://jamwithai.substack.com/p/building-data-pipelines-academic-research
到这里,PostgreSQL 里已经有一批带结构化正文的 CS.AI 论文,/api/v1/papers 能列出它们,Airflow 也会每天照这个流程再灌一批新的。但"库里有数据"和"能搜到数据"之间还差一层:索引怎么定义、mapping 怎么设计、BM25 怎么算分、filter 与 boost 怎么用。下一章开始动 OpenSearch,把这批论文真正变成可检索的搜索底座。