第 5 章:第四周:分块策略与混合检索(RRF 融合)
第 5 章:第四周:分块策略与混合检索(RRF 融合)
这一章解决什么问题?第 3 章结束时,系统里有一个能用的 BM25 关键词检索:OpenSearch 里存整篇论文,/api/v1/search 拿 query 匹配 title、abstract 和全文,按 BM25 打分返回。它能精确命中术语,但用户问"这篇论文怎么处理长文档的上下文丢失"时,措辞对不上原文就什么都搜不到。Week 4 补两件事:先把整篇论文切成语义自洽的 chunk,再为每个 chunk 生成向量,两路各自召回后用 RRF 融合成一个排序。切分质量不行、向量再准也没用,所以从切块讲起。
为什么分块质量决定混合检索上限
混合检索的本质是两路召回后做排序融合。BM25 那一路看词项统计,向量那一路看 1024 维空间里的语义邻近度,两路都只能看到索引里已有的检索单元。若检索单元是整篇论文,BM25 的文档长度归一化会把长文稀释得很难打分,向量则把整篇论文压成一个点,摘要、方法、实验混在一起,query 问哪一部分相似度都停在中间值。
Week 4 的目标是"intelligently breaking documents into searchable chunks"。chunk 是混合检索的最小可检索单位,切点决定召回上限——RRF 只能对已有候选重排,造不出没被召回的内容。切得太大,一块里混着多个主题,向量被平均掉;切得太碎,BM25 的 fuzziness: AUTO 也救不回来。
Week 4 的做法是尽量少用"按固定字符数硬切"这套,改用文档自身的结构信息。
Section-Based Chunking:用文档结构决定切点
chunking 实现位于 src/services/indexing/text_chunker.py,入口是 TextChunker.chunk_paper():
# Located in: src/services/indexing/text_chunker.py
TextChunker.chunk_paper(
    title="Paper Title",
    abstract="Abstract text",
    full_text="Complete paper content",
    sections=parsed_sections_dict,
    target_words=600,
    overlap_words=100
)
四个参数里 sections 是关键。Week 2 用 Docling 解析 PDF 时已拿到章节结构,Week 4 直接复用:有 sections 就在章节边界切,没有的退化成按段落切。源材料把这种"自适应处理"列为设计目标,因为不是所有入库文档都解析出了干净的章节层级。
参数取值来自 config.py,README 给出的口径是被测试调优过的:
# Chunking Parameters (optimized through testing)
CHUNK_SIZE = 600        # Target words per chunk
OVERLAP_SIZE = 100      # Words overlapping between chunks
MIN_CHUNK_SIZE = 100    # Minimum viable chunk size
SECTION_BASED = True    # Use document structure when available
CHUNK_SIZE=600 是目标而非硬约束:章节内容不足 600 词时按实际长度出块,超过时在章节内部继续切;MIN_CHUNK_SIZE=100 丢弃太短的尾块,避免索引里塞满噪声。OVERLAP_SIZE=100 是相邻 chunk 之间的重叠词数,防止关键句子正好落在切点上被一分为二——上一块的结尾句子在下一块里重新出现一次,检索时至少有一块保留完整表述。重叠的代价是索引膨胀:100/600 约 17% 冗余存储,拿空间换召回。
对应的环境变量是:
# Chunking Configuration
CHUNKING__CHUNK_SIZE=600
CHUNKING__OVERLAP_SIZE=100
CHUNKING__MIN_CHUNK_SIZE=100
CHUNKING__SECTION_BASED=true
源材料把 chunking 的收益归纳成四条:尊重文档自然边界、overlap 防止边界信息丢失、query 更容易匹配到相关内容、可处理 1,000 到 100,000+ 词的文档。前两条是切分本身的功劳,后两条要等 embeddings 和 RRF 接上才成立。
Embedding 接入:Jina AI 与失败回退
每个 chunk 除了 chunk_text 还要落一个向量字段,维度由配置固定:
# OpenSearch Configuration
OPENSEARCH__INDEX_NAME=arxiv-papers
OPENSEARCH__CHUNK_INDEX_SUFFIX=chunks
OPENSEARCH__VECTOR_DIMENSION=1024
OPENSEARCH__INDEX_NAME 与 OPENSEARCH__CHUNK_INDEX_SUFFIX 拼出来的 chunk 索引名是 arxiv-papers-chunks;Week 3 的整篇论文索引保留不动,两种粒度并存。
向量来自 Jina AI:src/services/embeddings/jina_client.py 封装调用,factory.py 提供 make_embeddings_service() 构造入口,上层不直接依赖具体实现:
# Located in: src/services/embeddings/factory.py
embeddings_service = make_embeddings_service()
vectors = await embeddings_service.embed_query(["query text"])
注意 embed_query 接收列表:批量提交省掉往返开销。索引阶段和检索阶段必须用同一个模型生成向量——两边不一致,向量空间就对不上,这是最容易在上线后才发现的问题。
接入外部服务的工程重点在失败路径。源材料的策略是"graceful degradation to BM25 when embeddings unavailable":生成失败、JINA_API_KEY 没配或 Jina 侧限流时,请求不报错,自动降级成纯 BM25。精度下降,但接口还能用。配套手段是批量处理、缓存高频 query 的 embedding、遵守 Jina AI 的 1000 requests/minute 限制。
失败模式在接口层可观察:search_mode 会告诉你实际跑了哪种模式。排查用两条命令:
# Check embedding service
curl -X POST "http://localhost:8000/api/v1/hybrid-search/" \
  -H "Content-Type: application/json" \
  -d '{"query": "test", "use_hybrid": true}'

# Check logs for embedding errors
docker compose logs api | grep -i embedding
RRF 融合原理与手动实现
两路检索的分数不可比:BM25 是无界分数,向量相似度是另一个量纲。两边 score 直接相加或加权平均,等于让量纲决定排序,换个语料就要重调系数。RRF(Reciprocal Rank Fusion)绕开这个问题——只用排名,不用分数:
每一路里第 r 名(从 1 开始)的文档贡献 1 / (k + r),最终分数是它在各路贡献之和。BM25 的第 1 名和向量的第 1 名贡献相同,两路都排得靠前的文档自然浮上来;融合对分数量纲免疫,"两路都认为相关"就是最强信号。
Week 4 的实现细节有两个值得记的点。一是手动融合:源材料明确写了 "Manual fusion algorithm (OpenSearch 2.19 compatibility)",即不用 OpenSearch 的 hybrid query 或 search pipeline,而在 search_unified() 里分别发两次查询、自己在 Python 侧算 RRF。代价是多一次网络往返和一段应用层代码,收益是把融合逻辑握在自己手里、不受引擎版本限制。二是可配权重("Configurable balance between keyword and semantic relevance"),可以在关键词与语义之间调平衡。同样带 fallback:向量那一路失败时,结果直接退回 BM25 排序。
融合流程在源材料里写得很清楚:
**Hybrid Query** (RRF manual fusion):
1. Execute BM25 query → get ranked results
2. Execute vector query → get ranked results
3. Apply RRF fusion algorithm → combine rankings
4. Return merged results with hybrid scores
BM25 那一路的 query DSL 沿用了 Week 3 的多字段加权思路,chunk_text 开 fuzziness: AUTO 容忍拼写偏差,title 和 abstract 用 boost 提权:
{
  "query": {
    "bool": {
      "should": [
        {"match": {"chunk_text": {"query": "machine learning", "fuzziness": "AUTO"}}},
        {"match": {"title": {"query": "machine learning", "boost": 2.0}}},
        {"match": {"abstract": {"query": "machine learning", "boost": 1.5}}}
      ]
    }
  }
}
boost: 2.0 与 boost: 1.5 是人工先验:标题命中比正文命中更能说明相关。这些系数没有自动调优,属于上线后按效果迭代的参数。
统一搜索 API:单索引、三种模式
统一入口是 src/services/opensearch/client.py 的 search_unified():
# Located in: src/services/opensearch/client.py
results = opensearch_client.search_unified(
    query="machine learning",
    query_embedding=vector,
    use_hybrid=True,
    size=10
)
query 走 BM25,query_embedding 走向量,use_hybrid 决定要不要做 RRF 融合。三种模式(keyword / vector / hybrid)共用同一个索引 arxiv-papers-chunks,差别只在检索路径。
封装它的是 FastAPI 路由 src/routers/hybrid_search.py,暴露 POST /api/v1/hybrid-search/。请求体把过滤和分页一起带上:
{
  "query": "transformer neural networks",
  "use_hybrid": true,
  "size": 10,
  "from": 0,
  "categories": ["cs.AI", "cs.LG"],
  "latest_papers": false,
  "min_score": 0.0
}
响应同时返回 chunk 级信息与论文级元数据,search_mode 回显本次实际模式:
{
  "query": "transformer neural networks",
  "total": 15,
  "hits": [
    {
      "arxiv_id": "2508.18563v1",
      "title": "Paper Title",
      "authors": "Author Names",
      "abstract": "Paper abstract...",
      "score": 0.8542,
      "chunk_text": "Relevant chunk content...",
      "chunk_id": "chunk_uuid",
      "section_name": "Related Work"
    }
  ],
  "size": 10,
  "from": 0,
  "search_mode": "hybrid"
}
section_name 是新增字段,也是给人看的证据:命中的是"Related Work"还是"Experiments",直接说明结果为什么相关。chunk_id 用于把多个 chunk 归并回同一篇论文时去重。端点复用了 Week 3 的 categories filter 与 latest_papers 时间控制,索引映射里的 paper_categories、published_date 就是为这些过滤准备的:
{
  "arxiv_id": "2508.18563v1",
  "title": "Paper title",
  "chunk_text": "Chunk content...",
  "chunk_id": "unique_chunk_identifier",
  "section_name": "Introduction",
  "embedding": [0.123, 0.456, ...],  // 1024 dimensions
  "paper_categories": ["cs.AI", "cs.LG"],
  "published_date": "2025-08-25T23:43:33"
}
数据流与系统组件
整条链路是一根直线,任何一段出问题都会拉低下游检索质量:
Raw Papers → PDF Parsing → Section Extraction → Chunking → Embedding → Indexing → Search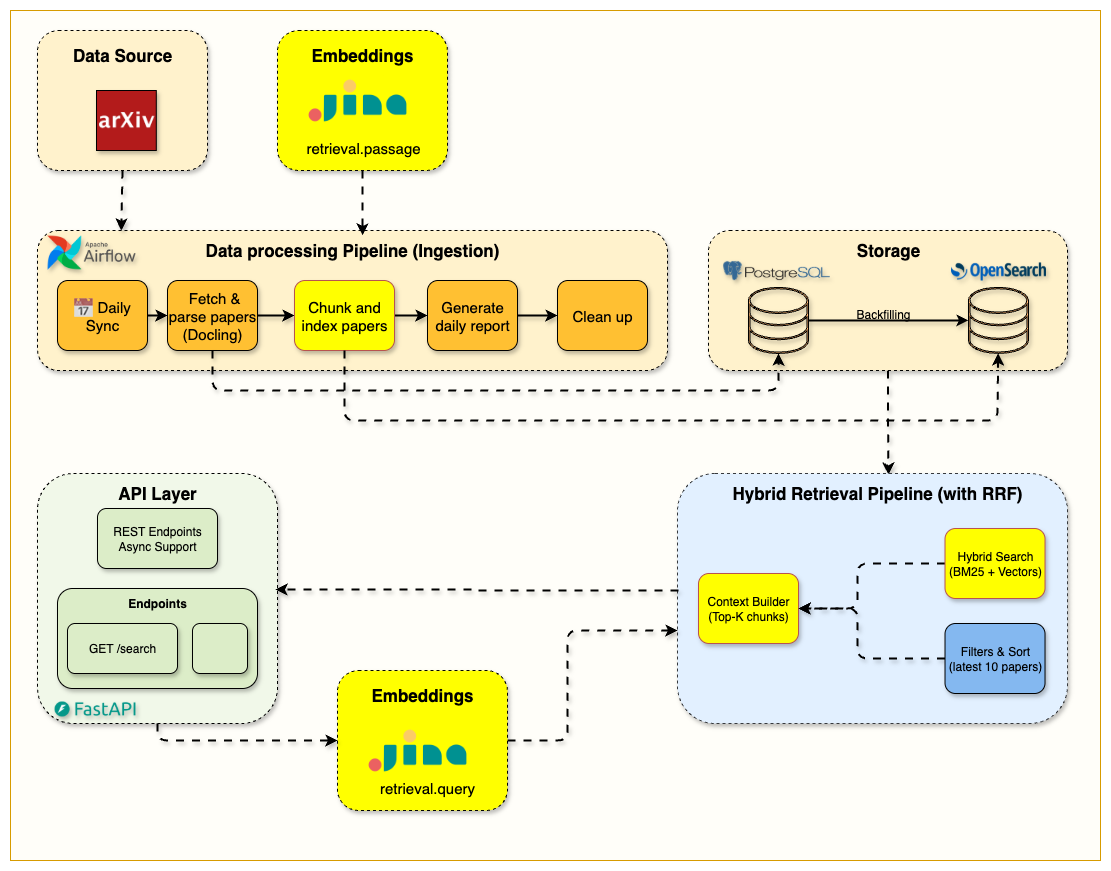
图里交代了四层结构:数据处理管道负责 chunking 与 embedding;单一 OpenSearch 索引承载 BM25、vector 与 hybrid 三种模式;混合检索管道做 RRF 融合;最上层是 FastAPI 带自动 embedding 生成的接口。索引是唯一汇合点——切块和 embedding 的质量问题都在这里沉积,到查询时才暴露。
各组件代码落点:
src/
├── routers/
│   └── hybrid_search.py          # FastAPI endpoints
├── services/
│   ├── opensearch/
│   │   ├── client.py              # Unified search client
│   │   ├── factory.py             # Client factory
│   │   └── index_config_hybrid.py # Index configuration
│   ├── indexing/
│   │   ├── text_chunker.py        # Section-based chunking
│   │   ├── hybrid_indexer.py      # Document indexing
│   │   └── factory.py             # Indexing service factory
│   └── embeddings/
│       ├── jina_client.py         # Jina AI client
│       └── factory.py             # Embedding service factory
├── schemas/
│   └── api/
│       └── search.py              # Request/response models
└── config.py                      # Configuration management
factory.py 出现三次(opensearch、indexing、embeddings),对应开关都在配置里:JINA_API_KEY 决定 embeddings 走真实现还是降级,OPENSEARCH__* 决定连哪个索引。生产侧最小 OpenSearch 配置也给了:
# Recommended minimum for production
opensearch:
  image: opensearchproject/opensearch:2.19.0
  environment:
    - cluster.name=rag-cluster
    - node.name=rag-node-1
    - discovery.type=single-node
    - OPENSEARCH_JAVA_OPTS=-Xms1g -Xmx1g
  deploy:
    resources:
      limits:
        memory: 2G
      reservations:
        memory: 1G
discovery.type=single-node 和 2G 上限说明这是单机演示级配置,非集群方案;向量检索吃内存,扩容时第一件要动的是 JVM heap。
效果与成本取舍
源材料给的 benchmark 口径写在表头上:3 篇论文、81 个 chunk、单节点 OpenSearch。
| Search Type | Avg Response Time | Throughput | Recall@10 | Precision@10 |
|---|---|---|---|---|
| BM25 Only | 52ms | ~200 req/s | 0.78 | 0.65 |
| Vector Only | 105ms | ~95 req/s | 0.82 | 0.71 |
| Hybrid (RRF) | 2.4s | ~25 req/s | 0.89 | 0.84 |
三点结论直接决定架构。第一,混合检索 relevance 最好,召回和精确率都高于单路,但延迟是 BM25 的四十多倍。第二,2.4s 里约 2s 花在 embedding 生成上("Embedding generation accounts for ~2s of hybrid search time"),瓶颈不在 OpenSearch,而在外部 embedding API——优化方向是缓存 query embedding 和批量处理,不是换检索引擎。第三,BM25 的 ~50ms 和 ~200 req/s 在延迟敏感场景依然有位置:自动补全、高频重复查询、embedding 服务不可用时的降级路径,都靠它兜底。
按模式选场景:BM25 管精确关键词匹配,Vector 管语义相似,Hybrid 用于"best overall relevance"。落到接口上就是默认参数:面向用户的问答走 hybrid,批量任务和高 QPS 场景走 BM25。
上线后要盯的指标是这四个方向:检索延迟 p50、p95、p99;embedding 生成成功率;索引文档数与体积;BM25 与 Hybrid 的调用分布——最后一项能提前告诉你降级是否在悄悄发生。健康检查覆盖 OpenSearch 集群状态、embedding 可用性和索引文档数校验。
索引侧的坑:索引不存在或文档数为 0 时返回空结果,先用这两条命令排除:
# Verify index exists and has documents
curl "http://localhost:9200/arxiv-papers-chunks/_count"

# Check index mapping
curl "http://localhost:9200/arxiv-papers-chunks/_mapping"
JINA_API_KEY 没注入容器时 embedding 会静默失败并降级,先查注入再直连 Jina 验证模型名:
# Check Jina API key configuration
docker compose exec api env | grep JINA

# Test direct embedding service
curl -X POST "https://api.jina.ai/v1/embeddings" \
  -H "Authorization: Bearer $JINA_API_KEY" \
  -d '{"model": "jina-embeddings-v3", "input": ["test"]}'
Week 4 的 notebook 覆盖完整验证路径:环境健康检查、chunking 演示、真实 Jina embedding 生成、三种搜索模式、生产 API 测试、性能对比。跑完这套,检索层就可以交给 Week 5 去接 LLM 了。
参考链接
- 课程主仓库:jamwithai/production-agentic-rag-course
- Week 4 说明文档:notebooks/week4/README.md
- Week 4 notebook:notebooks/week4/week4_hybrid_search.ipynb
- 分块实现:src/services/indexing/text_chunker.py
- 统一搜索客户端:src/services/opensearch/client.py
- 索引配置:src/services/opensearch/index_config_hybrid.py
- 混合检索 API:src/routers/hybrid_search.py
- Jina AI client:src/services/embeddings/jina_client.py
- Embedding 工厂:src/services/embeddings/factory.py
- 配套博客:The Chunking Strategy That Makes Hybrid Search Work
- 代码发布:week4.0
- OpenSearch 文档:https://opensearch.org/docs/
- Jina AI Embeddings:https://jina.ai/embeddings/
- RRF 原始论文:Cormack et al., Reciprocal Rank Fusion
到这里检索层就完整了:一个索引、一个端点、三种模式,切块和向量的每一步都有明确的降级路径。Week 5 会把 /api/v1/hybrid-search/ 的结果塞进 Ollama 的上下文,让检索出来的 chunk 变成带引用的回答。