第 7 章:第六周:可观测性与缓存,让 RAG 能上生产
第 7 章:第六周:可观测性与缓存,让 RAG 能上生产
Week 5 结束时,RAG 已经能回答问题,能流式输出,Gradio 界面跑在 7861 端口上。但一个能回答问题的系统和一个能上生产的系统之间还差两件事:慢了、错了,你无法解释时间花在哪里;同一个问题被问第二遍,全部昂贵的工作又重算一次。第六周补的正是这两块——Langfuse 让你看见流水线内部,Redis 让重复请求不必重算。这一章讲清楚两者的接入点、设计取舍,以及源材料给出的实测数字和口径。
7.1 可观测性在生产里要回答的具体问题
线上报障通常只有一句话:"刚才那个问题等了很久。"你无法从这句话判断是 OpenSearch 检索慢、Jina Embedding 接口慢,还是 Ollama 生成慢。Week 5 做过 prompt 瘦身(官方 README 给出的口径是 prompt 减少 80%,换来 6x 提速),但这类优化靠一次性基准测试证明,线上没有持续的度量。
还有几类问题只有采集起来才看得见:哪些 query 反复出现(直接决定缓存值不值得做)、请求成功率是多少、返回的答案有没有真的引用到检索到的论文、单次请求烧掉多少 token。第六周的 learning objectives 把这些目标写得很直接——end-to-end RAG pipeline tracing、intelligent cache keys and TTL management、latency 与 cost 的实时看板。观测不是加个日志,而是先把"要回答哪些问题"列出来,再决定埋点位置。
7.2 trace 与 span:把 15 秒拆开归因
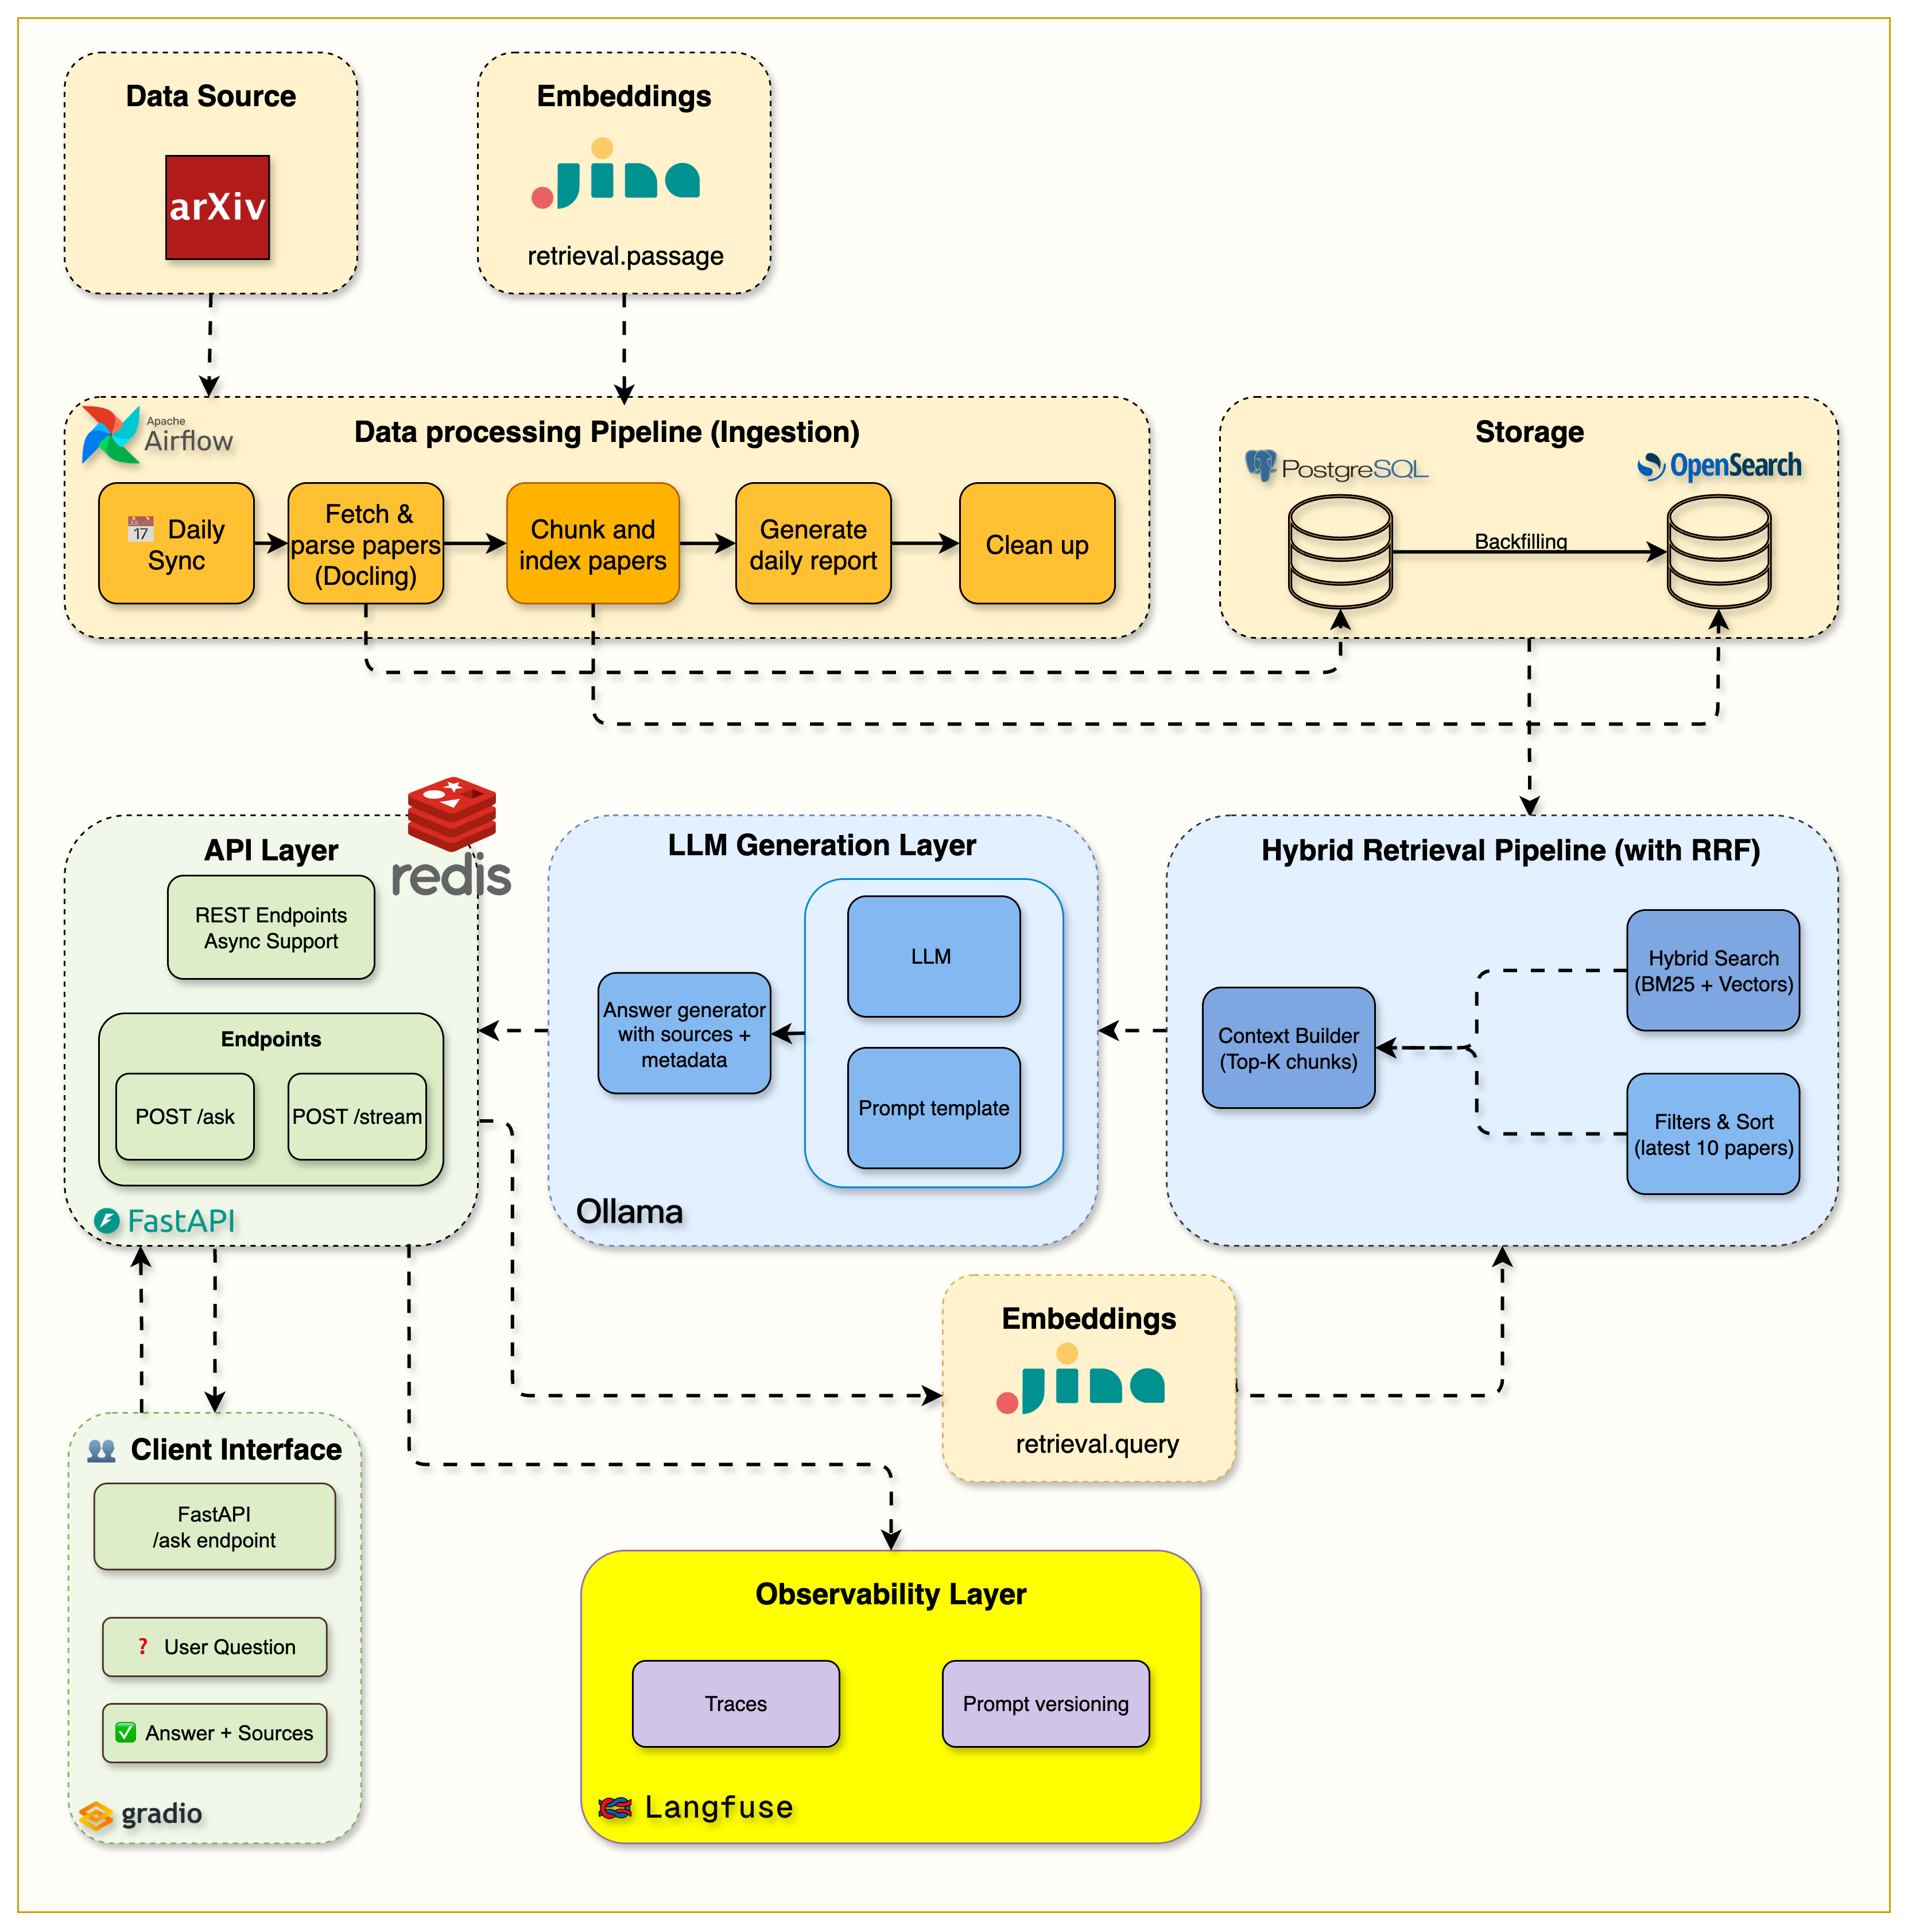
Langfuse 的接入点在 src/services/langfuse/,README 的措辞是 complete RAG pipeline tracing with performance breakdowns。要做出 breakdown,就得有层级:一次 /api/v1/ask 请求是一个 trace,检索、Embedding、生成这些阶段各自是 trace 下的 span,每个 span 有自己的耗时。只有这样,15-20 秒的端到端延迟才能落到具体阶段上,而不是停留在一个总数。
落地方式值得注意:README 描述的是 updated endpoints,src/routers/ask.py 里集成了 tracing 和 caching middleware。也就是说,缓存和 trace 都挂在 API 这一层,检索服务和 Ollama 服务的业务代码不需要为了被观测而改签名。这一点在选观测方案时是要写进评估标准的——如果接入 tracing 要求改动每个业务函数的签名和返回值,团队维护几周之后就会把它删掉。
除了耗时,Langfuse 还记录 user analytics、query patterns、success rate,以及 answer relevance 与 source attribution。前几项回答的是容量与产品问题:哪些查询是热点、失败集中在什么模式。后两项回答的是质量问题:答案是否贴题、引用的来源是否真的支撑了答案。
7.3 本地起一个 Langfuse 实例
第六周的 docker-compose.yml 加了两样东西:Redis service 和 Langfuse 本地实例,README 的服务表里 Langfuse Dashboard 指向 http://localhost:3000。同时接两套观测与缓存组件,如果都要求注册云账号,本地开发的第一步就会卡住,所以 Langfuse 是自带实例的。
配置项只有四个,LANGFUSE__PUBLIC_KEY 与 LANGFUSE__SECRET_KEY 在根 README 里被标为 Week 6 optional——不填不影响问答链路,只是没有 trace:
# Required environment variables
LANGFUSE__SECRET_KEY=sk_lf_your_secret_key
LANGFUSE__PUBLIC_KEY=pk_lf_your_public_key
REDIS__HOST=redis
REDIS__TTL_HOURS=24
不想要本地实例的话,把 dashboard 指到 https://cloud.langfuse.com 也能看同样的数据。排障路径也很短,README 的表格只给了两条:没有 trace 就检查 LANGFUSE__* 环境变量;缓存不工作就先 redis-cli ping,确认 Redis 通不通。健康检查可以走 curl "http://localhost:8000/api/v1/health"。
# Start with tracing and caching enabled
docker compose up --build -d
7.4 精确匹配缓存:键设计与 TTL
Week 6 做的是 exact-match,不是语义相似缓存。cache key 是 parameter-aware 的,同一个 query 在不同参数下必须落到不同 key。README 的测试命令里,top_k 就是这种参数的例子:
# First request (cache miss ~15-20s)
curl -X POST "http://localhost:8000/api/v1/ask" \
  -H "Content-Type: application/json" \
  -d '{"query": "What are transformers?", "top_k": 3}'
两条请求的 query 完全相同,top_k 都是 3。只要用户把 top_k 改成 5,检索到的 chunk 集合就变了,Prompt 变了,答案自然也该重算。如果把参数排除在 key 之外,用户调参之后会拿到上一次的结果,而且不会有任何报错——这类 bug 在观测看板上表现为"命中率很高",在用户侧表现为"改了参数没反应"。
TTL 默认 24 小时,由 REDIS__TTL_HOURS 控制。选 24 小时的理由和语料有关:arXiv 论文的正文不会在一天内变化,答案的有效期应该由数据决定,而不是由缓存组件的能力决定。反过来说,缓存如果无限期留着,旧 prompt、旧模型版本产出的答案会继续发给用户,而 trace 上看不出异常。TTL 在这里的作用是版本封条。
未命中的降级路径按 README 的 data flow 走完整流水线:
Query → Cache Check → [Hit: ~100ms] | [Miss: Full Pipeline ~15s] → Cache Store → Langfuse TraceCache Store 排在流水线之后、Trace 之前。miss 不是错误路径,是正常路径,只是贵。缓存服务在 src/services/cache/,README 强调的是 graceful fallback:Redis 不可用时请求仍应走完整流水线返回答案,而不是抛 500。缓存是加速器,不能变成新的单点依赖。
7.5 缓存收益的实测口径
验证方式是连着发两次同样的请求:
# Second identical request (cache hit ~100ms)
curl -X POST "http://localhost:8000/api/v1/ask" \
  -H "Content-Type: application/json" \
  -d '{"query": "What are transformers?", "top_k": 3}'
README 给出的 benchmark 表如下:
| Scenario | Response Time | Improvement |
|---|---|---|
| Cache Miss | 15-20 seconds | Baseline |
| Cache Hit | 50-100ms | 150-400x faster |
| Monitoring Overhead | <2% | Negligible impact |
口径要说清楚:这组数字来自这套本地栈的实测,miss 的 15-20 秒包含 Hybrid Search(BM25 + Vector)、Embedding 调用和 Ollama 本地生成,hit 只花一次 Redis 往返。150-400x 之所以是一个区间而不是一个数,是因为被除数本身在 15-20 秒之间浮动,除数又落在 50-100ms 之间。换模型、换硬件、换 Embedding 服务商,这些数字都会变,但量级来源不变:时间几乎全在 LLM 生成与检索上,缓存命中的部分被整段切掉了。monitoring overhead 低于 2%,是"观测要不要全量开"这个问题的答案——在这个量级上不值得为省开销做采样。
7.6 成本看板与后续可做的事
Langfuse 的看板实时展示 cost 和 usage 指标,前者回答"这一周花了多少、哪个环节花得多",后者回答"请求量涨了多少、token 消耗有没有跟着涨"。这两条曲线放在一起看,才能判断一次性能变化是来自流量增长还是来自某次改动。关于项目本身的成本,根 README 的说明是:本地开发 $0,可选的云 API 大约 $2-5。也就是说这套观测与缓存方案没有把项目推向付费依赖——Ollama 本地跑生成,Redis 和 Langfuse 都起在本地 compose 里。
README 的 Next Steps 还列了四个没做的方向:semantic similarity caching(fuzzy matching)、custom dashboards 与 A/B testing、distributed caching 与 automated monitoring、user feedback 集成与 answer scoring。其中最值得琢磨的是第一个。exact-match 命中的前提是用户一字不差地把同一个问题问第二遍,而真实流量里换词、加限定语的情况更常见,所以语义缓存通常能再多拿一段命中率,代价是要在 key 之外维护一层相似度判断和阈值——阈值定高了不命中,定低了会把不该复用的答案端出去。README 把它标成 Future Enhancement,含义是第六周有意没做:先把精确匹配这条能解释、能验证的路走通,再谈模糊匹配。另外 user feedback 与 answer scoring 也说明了观测的下一步方向——从看延迟和成本,走到看答案质量。
实作部分在 Week 6 notebook 里,按根 README 的命令启动:
# Launch the Week 6 notebook
uv run jupyter notebook notebooks/week6/week6_cache_testing.ipynb
参考链接
- 课程仓库根 README(第六周目标、技术栈表、服务与端口、成本说明):https://github.com/jamwithai/production-agentic-rag-course/blob/main/README.md
- Week 6 notebook(Langfuse tracing 与 Redis 缓存的动手验证):https://github.com/jamwithai/arxiv-paper-curator/blob/main/notebooks/week6/week6_cache_testing.ipynb
- 对应的 Substack 博客:https://jamwithai.substack.com/p/production-ready-rag-monitoring-and
- 对应的代码 release tag:https://github.com/jamwithai/arxiv-paper-curator/releases/tag/week6.0
- Langfuse Dashboard:https://cloud.langfuse.com
- Redis 文档:https://redis.io/docs
第六周改动集中在四个位置:src/services/langfuse/、src/services/cache/、src/routers/ask.py 以及 docker-compose.yml。把这四处对着上面两条命令跑一遍——第一次看 miss 的耗时,第二次看 hit 的耗时,再去 http://localhost:3000 找那条 trace——第六周的内容就闭环了。