文本表示
本章来源:本文整理自 microsoft/AI-For-Beginners 的 lessons/5-NLP/13-TextRep/README.md,中文版为 Azure Co-op Translator 机器翻译。
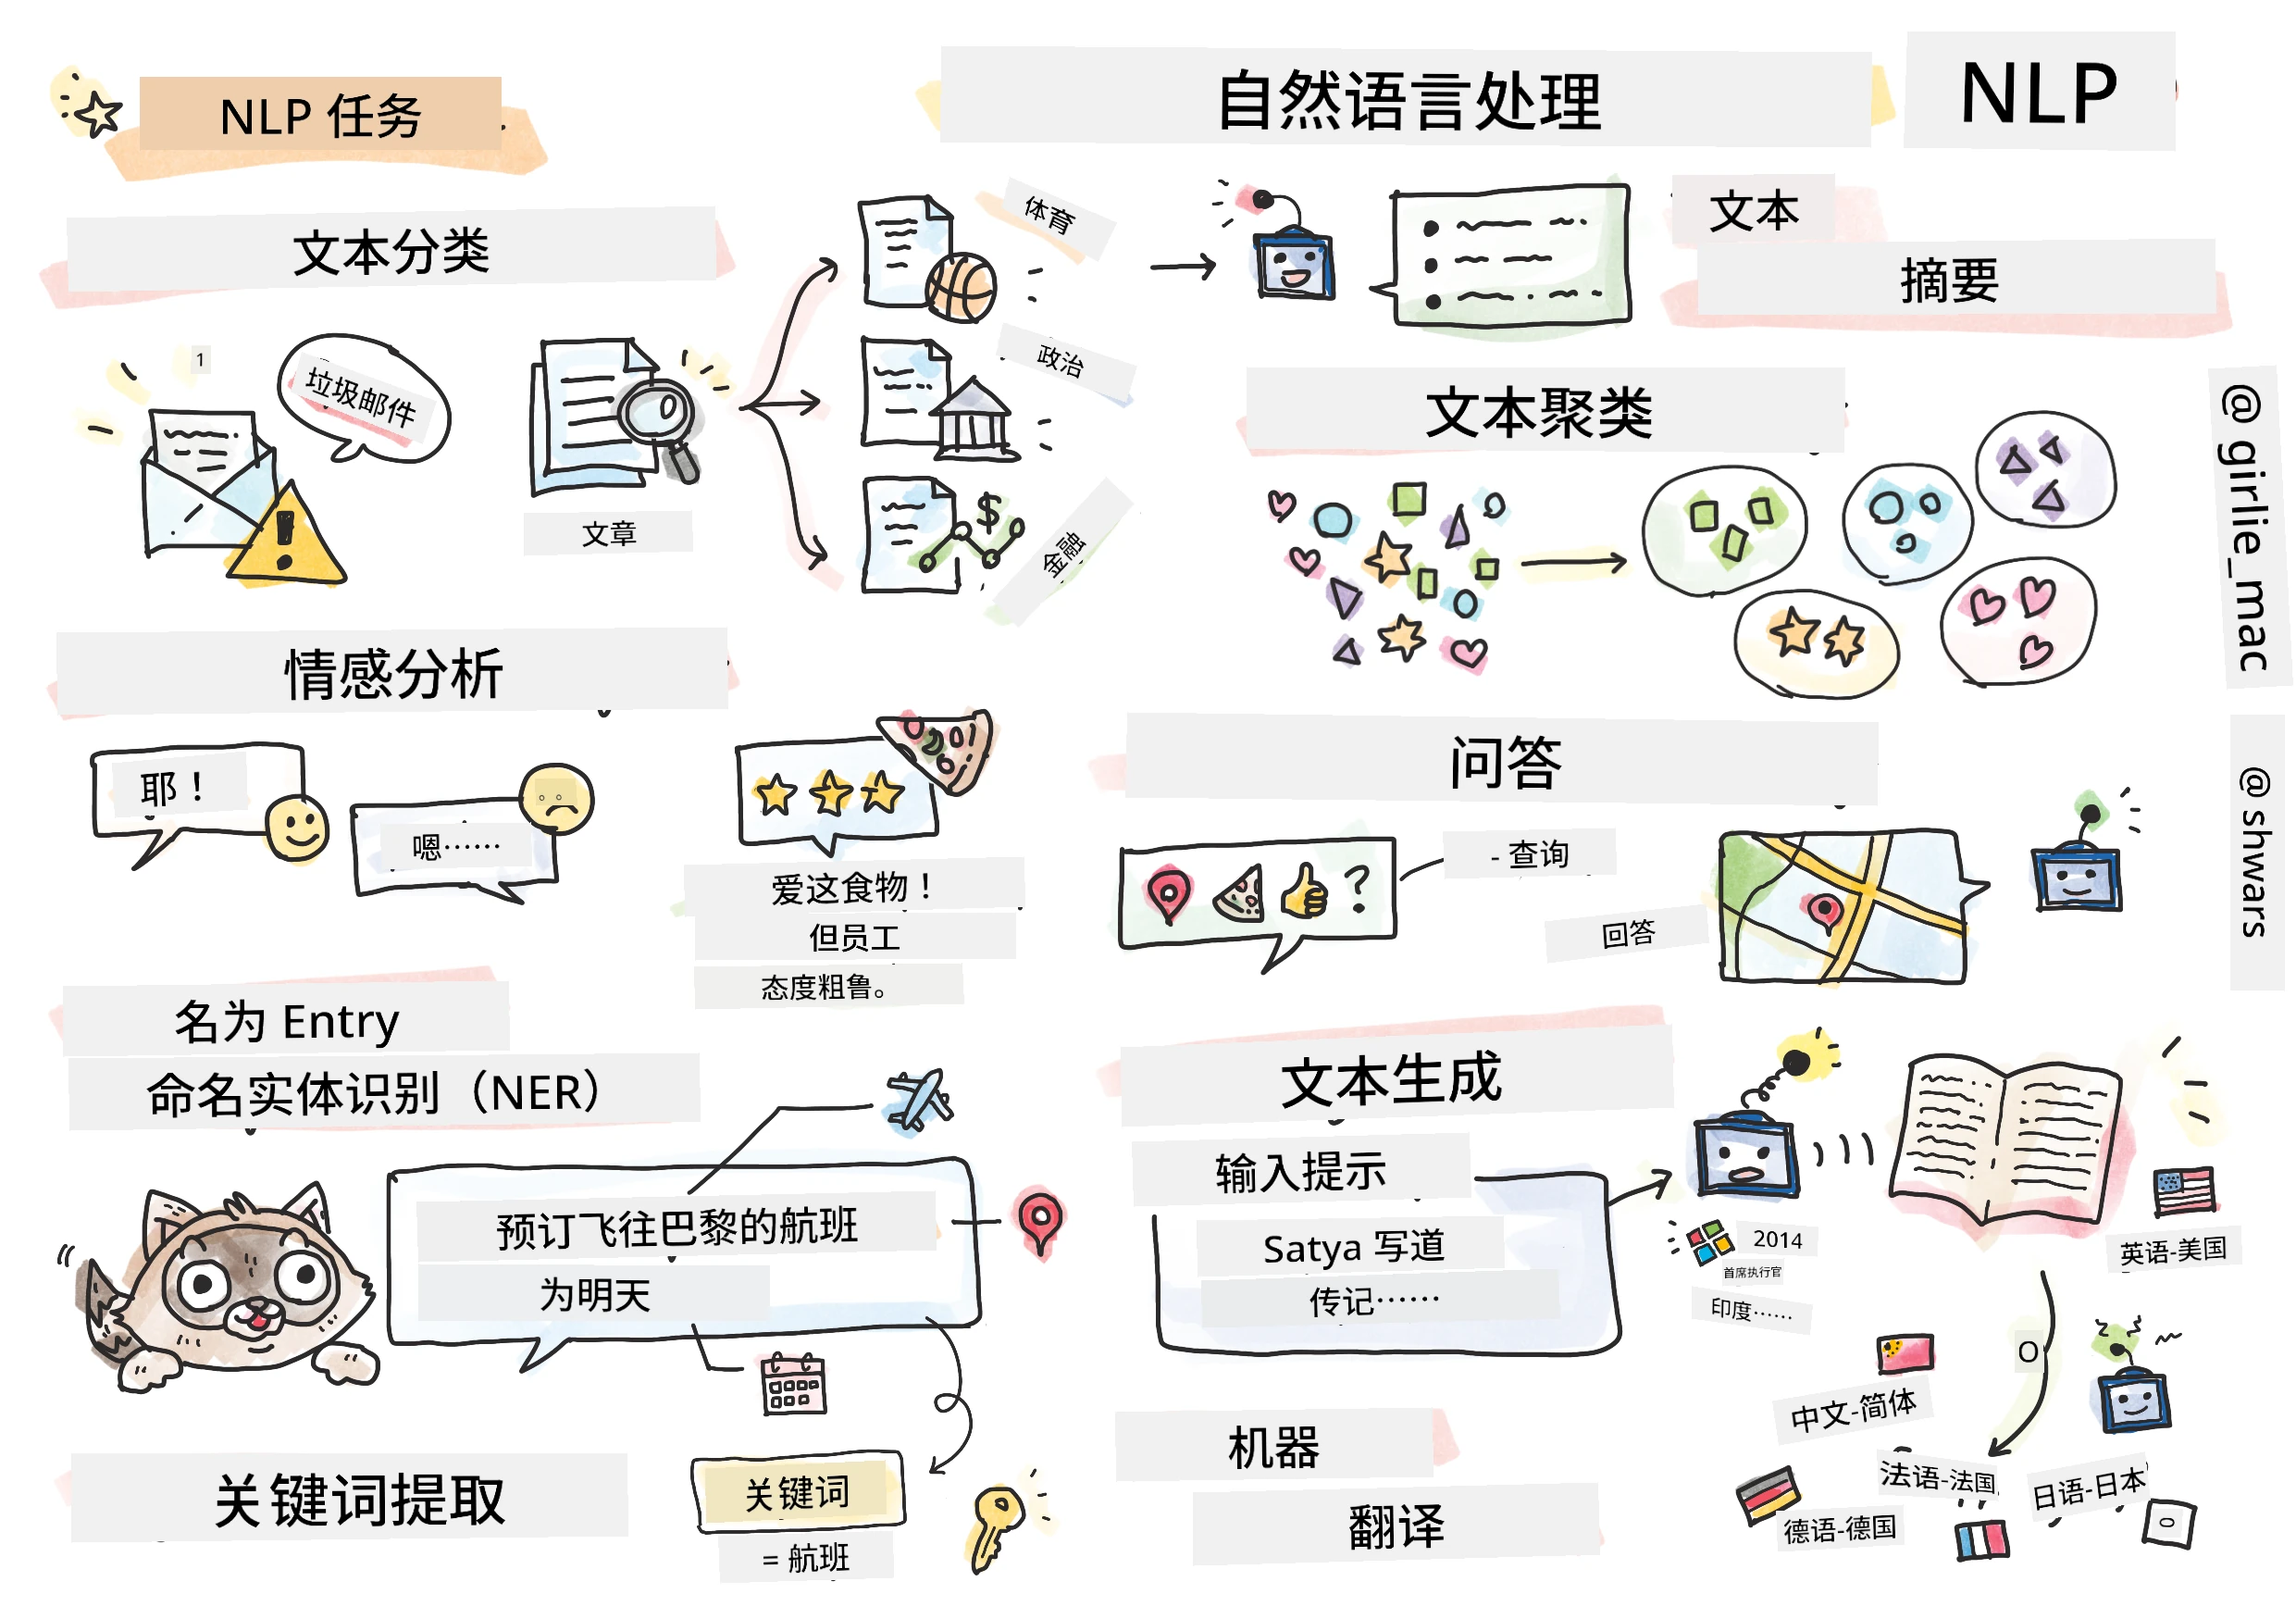
在本节中,我们将重点使用神经网络处理与自然语言处理(NLP)相关的任务。我们希望计算机能够解决许多NLP问题:
- 文本分类是一个典型的关于文本序列的分类问题。例子包括将电子邮件消息分类为垃圾邮件或非垃圾邮件,或将文章分类为体育、商业、政治等。同时,在开发聊天机器人时,我们常常需要理解用户的意图——这时我们处理的是意图分类。意图分类中通常需要处理很多类别。
情感分析是一个典型的回归问题,我们需要给句子含义的正负程度赋予一个数值(情绪值)。情感分析的更高级版本是基于方面的情感分析(ABSA),我们不是对整个句子赋予情感,而是对句子的不同部分(方面)赋予情感,例如 这家餐厅,我喜欢它的菜肴,但氛围很糟糕*。 命名实体识别(NER)指的是从文本中提取特定实体的问题。例如,我们需要理解短语 我明天需要飞往巴黎 中,明天 指的是日期,巴黎* 是位置。
- 关键词提取与NER类似,但我们需要自动提取对句子意义重要的词汇,而无需针对特定实体类型进行预训练。
- 文本聚类在我们希望将相似句子归为一组时非常有用,例如,在技术支持对话中相似的请求。
- 问答系统指模型回答具体问题的能力。模型输入一段文本和一个问题,需要在文本中找出包含问题答案的位置(或者有时直接生成答案文本)。
文本生成是模型生成新文本的能力。它可以被视为一个基于某个文本提示*预测下一个字母或单词的分类任务。先进的文本生成模型,如GPT-3,能够使用称为提示编程或提示工程的技术解决其他NLP任务如分类。
- 文本摘要是一种技术,我们希望计算机“阅读”长文本并将其总结成几句话。
- 机器翻译可以视为一种在一种语言上理解文本,在另一种语言上生成文本的结合。
最初,大多数NLP任务是用传统方法如文法来解决的。例如,在机器翻译中,解析器用于将初始句子转换为语法树,然后提取更高层次的语义结构来表示句子的含义,基于这个含义和目标语言的文法生成结果。如今,许多NLP任务更有效的解决方法是使用神经网络。
许多经典的NLP方法在自然语言处理工具包(NLTK) Python库中实现。网上有一本很棒的NLTK书籍,介绍了如何使用NLTK解决不同的NLP任务。
在我们的课程中,我们将主要关注使用神经网络处理NLP,并在需要时使用NLTK。
我们已经学习过如何使用神经网络处理表格数据和图像。这些数据与文本的主要区别在于,文本是可变长度的序列,而图像的输入大小是预先已知的。虽然卷积网络可从输入数据中提取模式,但文本中的模式更为复杂。例如,否定词与主语之间可以隔开任意多个词(如 我不喜欢橙子,和 我不喜欢那些又大又好吃的彩色橙子),但仍然应被视为一个模式。因此,为了处理语言,我们需要引入新的神经网络类型,如循环网络和transformer。
安装库
如果你在本地Python环境中运行本课程,可能需要使用以下命令安装所有NLP所需的库:
对于PyTorch
pip install -r requirements-pytorch.txt对于TensorFlow
pip install -r requirements-tf.txt你可以在Microsoft Learn上尝试使用TensorFlow进行NLP
GPU 注意事项
本节中,在一些示例里我们将训练相当大型的模型。
- 使用支持GPU的电脑:建议在支持GPU的计算机上运行笔记本,以减少使用大型模型时等待的时间。
- GPU内存限制:使用GPU时,训练大型模型可能会导致GPU内存不足。
- GPU内存消耗:训练时消耗的GPU内存量取决于多个因素,包括小批量大小。
- 尽可能减小小批量大小:遇到GPU内存问题时,可以尝试通过减小代码中的小批量大小来解决。
- TensorFlow GPU内存释放:较旧版本的TensorFlow在同一Python内核中训练多个模型时可能无法正确释放GPU内存。为有效管理GPU内存,你可以配置TensorFlow按需分配GPU内存。
- 代码示例:要设置TensorFlow仅按需增长GPU内存分配,可在笔记本中加入以下代码:
physical_devices = tf.config.list_physical_devices('GPU')
if len(physical_devices)>0:
tf.config.experimental.set_memory_growth(physical_devices[0], True) 如果你对从经典机器学习的角度学习NLP感兴趣,请访问这套课程
课前测验
文本分类
在本节的第一部分中,我们将专注于文本分类任务。我们将使用 AG News 数据集,该数据集包含如下新闻文章:
- 类别:科技
- 标题:Ky.公司获得研究肽类的资助(美联社)
- 正文:美联社 - 一家由路易斯维尔大学化学研究员创立的公司获得了一项开发资助...
我们的目标是根据文本将新闻项目分类到某个类别中。
表示文本
如果我们想用神经网络解决自然语言处理(NLP)任务,我们需要一种方法将文本表示为张量。计算机已经通过诸如 ASCII 或 UTF-8 等编码将文本字符表示为数字,这些数字映射到屏幕上的字体。
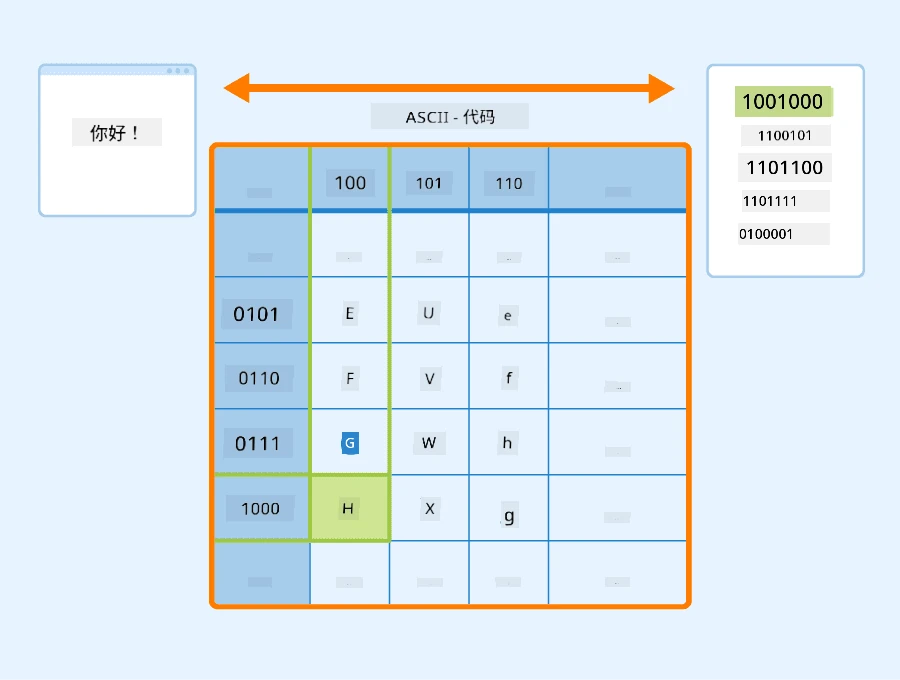
作为人类,我们理解每个字母代表什么,以及所有字符如何组合形成句子的单词。然而,计算机本身并没有这样的理解,神经网络需要在训练过程中学习这些含义。
因此,我们可以使用不同的方法来表示文本:
- 字符级表示,即将文本中的每个字符表示为一个数字。假设我们的文本语料库中有 C 个不同的字符,那么单词 Hello 将被表示为一个 5xC 的张量。每个字母对应于一个独热编码的张量列。
- 词级表示,即我们创建一个包含文本中所有单词的词汇表,然后使用独热编码表示单词。这种方法更好一些,因为单个字母本身没有太多意义,因此通过使用更高级的语义概念——单词——我们简化了神经网络的任务。然而,由于词汇表的规模较大,我们需要处理高维稀疏张量。
无论采用哪种表示方式,我们首先需要将文本转换为标记序列,一个标记可以是字符、单词,甚至是单词的一部分。然后,我们使用词汇表将标记转换为数字,这个数字可以通过独热编码输入到神经网络中。
N-Grams
在自然语言中,单词的确切含义只能在上下文中确定。例如,神经网络 和 捕鱼网络 的含义完全不同。考虑上下文的一种方法是基于单词对构建模型,并将单词对视为单独的词汇标记。这样,句子 I like to go fishing 将被表示为以下标记序列:I like,like to,to go,go fishing。这种方法的问题在于词汇表的规模显著增长,并且像 go fishing 和 go shopping 这样的组合被表示为不同的标记,尽管它们使用了相同的动词,但并没有共享任何语义相似性。
在某些情况下,我们可能会考虑使用三元组(tri-grams)——三个单词的组合。因此,这种方法通常被称为n-grams。此外,使用字符级表示时,n-grams 通常大致对应于不同的音节。
词袋模型和 TF/IDF
在解决文本分类等任务时,我们需要能够用一个固定大小的向量表示文本,这个向量将作为最终密集分类器的输入。最简单的方法之一是组合所有单个单词的表示,例如通过将它们相加。如果我们将每个单词的独热编码相加,我们将得到一个频率向量,显示每个单词在文本中出现的次数。这种文本表示被称为词袋模型(BoW)。
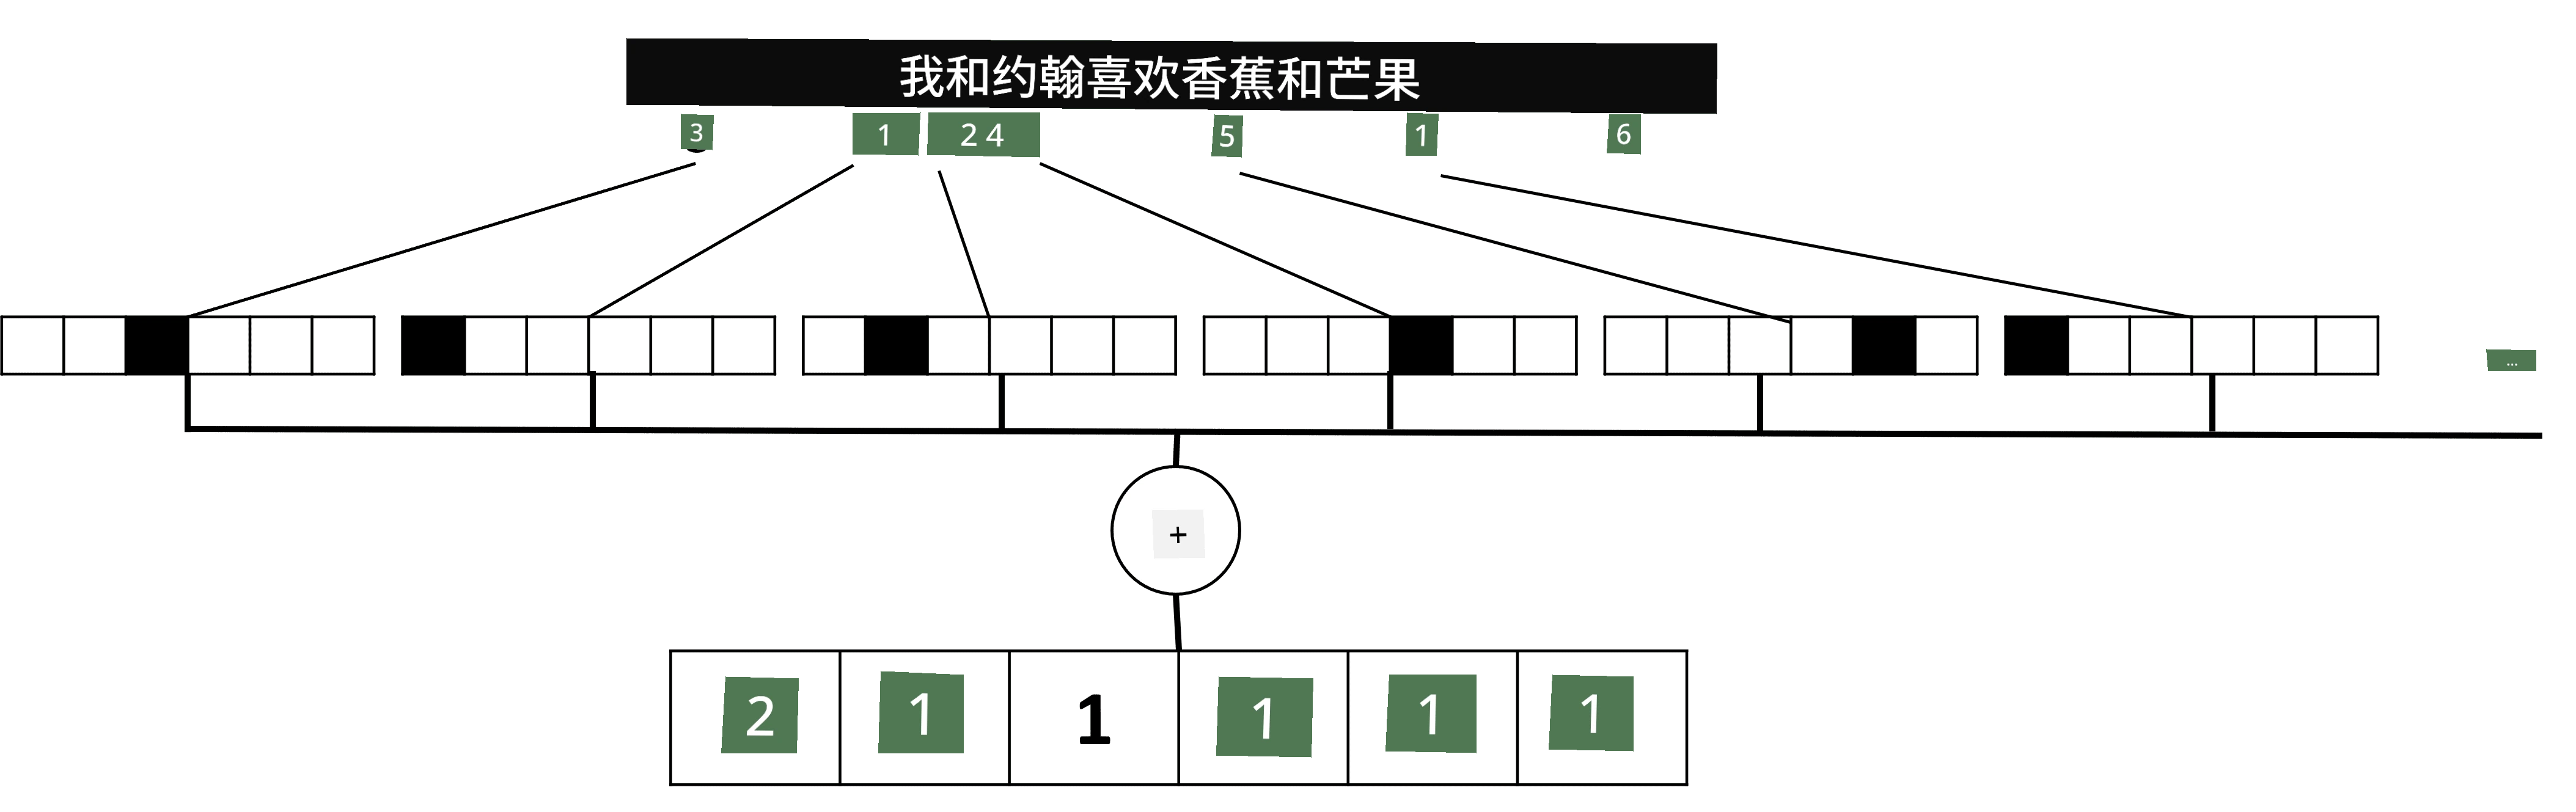
图片由作者提供
词袋模型本质上表示了文本中出现了哪些单词以及它们的数量,这确实可以很好地指示文本的内容。例如,关于政治的新闻文章可能包含 总统 和 国家 等词,而科学出版物可能包含 对撞机、发现 等词。因此,单词频率在许多情况下可以很好地指示文本内容。
词袋模型的问题在于某些常见单词,例如 and、is 等,出现在大多数文本中,并且它们的频率最高,从而掩盖了真正重要的单词。我们可以通过考虑单词在整个文档集合中出现的频率来降低这些单词的重要性。这就是 TF/IDF 方法的主要思想,该方法在本课附带的笔记本中有更详细的介绍。
然而,这些方法都无法完全考虑文本的语义。我们需要更强大的神经网络模型来实现这一点,我们将在本节后续内容中讨论。
✍️ 练习:文本表示
通过以下笔记本继续学习:
总结
到目前为止,我们已经学习了可以为不同单词添加频率权重的技术。然而,这些技术无法表示单词的含义或顺序。正如著名语言学家 J. R. Firth 在1935年所说:“单词的完整意义总是与上下文相关,任何脱离上下文的意义研究都不能被认真对待。”我们将在课程后续内容中学习如何通过语言建模从文本中捕获上下文信息。
🚀 挑战
尝试使用词袋模型和不同的数据模型完成一些其他练习。你可以参考这个 Kaggle 比赛 来获得灵感。
课后测验
复习与自学
在 Microsoft Learn 上练习你的文本嵌入和词袋模型技术。