神经网络入门:感知机
本章来源:本文整理自 microsoft/AI-For-Beginners 的 lessons/3-NeuralNetworks/03-Perceptron/README.md,中文版为 Azure Co-op Translator 机器翻译。
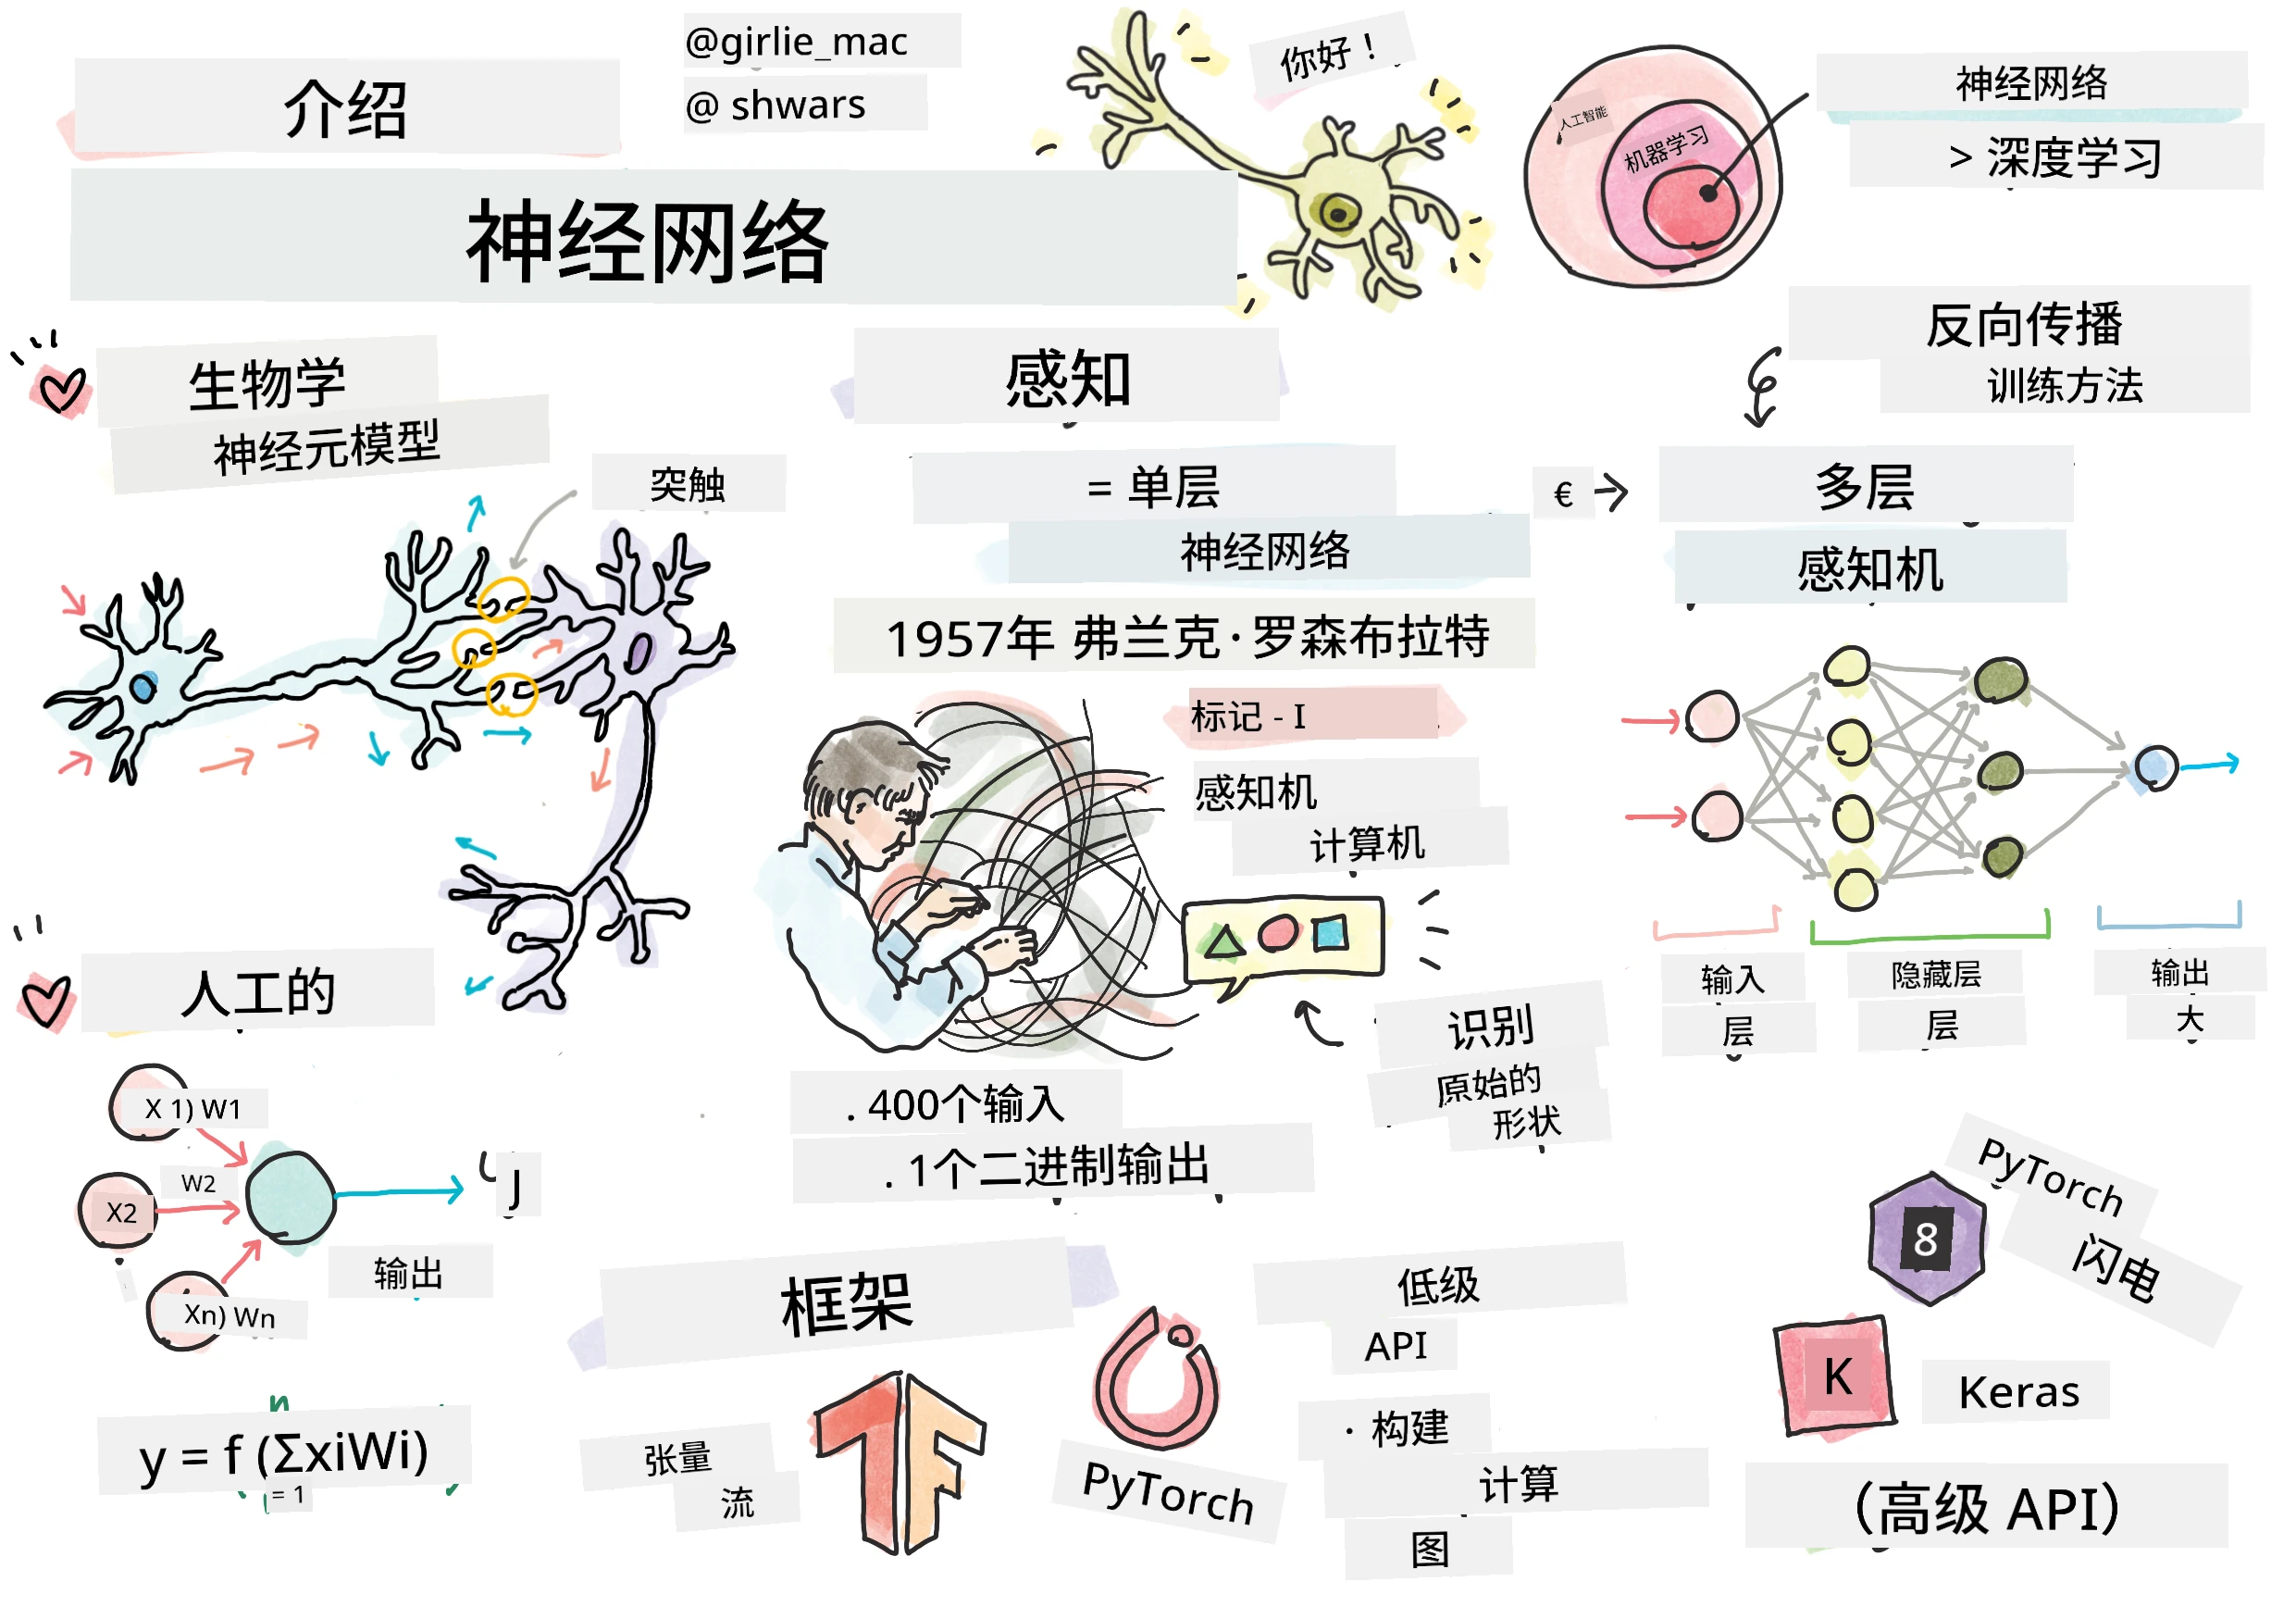
正如我们在介绍中讨论的那样,实现智能的一种方法是训练一个计算机模型或一个人工大脑。自20世纪中期以来,研究人员尝试了各种数学模型,直到近年来,这一方向取得了巨大的成功。这些大脑的数学模型被称为神经网络。
有时神经网络被称为人工神经网络(Artificial Neural Networks,ANNs),以表明我们讨论的是模型,而不是真实的神经元网络。
机器学习
神经网络属于一个更大的学科,称为机器学习,其目标是利用数据训练计算机模型,使其能够解决问题。机器学习是人工智能的重要组成部分,但我们在本课程中不涉及经典的机器学习内容。
请访问我们的独立课程 机器学习入门,了解更多关于经典机器学习的内容。
在机器学习中,我们假设有一些示例数据集 X 和对应的输出值 Y。示例通常是由特征组成的N维向量,而输出被称为标签。
我们将讨论两种最常见的机器学习问题:
- 分类:需要将输入对象分类到两个或多个类别中。
- 回归:需要为每个输入样本预测一个数值。
当将输入和输出表示为张量时,输入数据集是一个大小为 M×N 的矩阵,其中 M 是样本数量,N 是特征数量。输出标签 Y 是一个大小为 M 的向量。
在本课程中,我们将仅关注神经网络模型。
神经元的模型
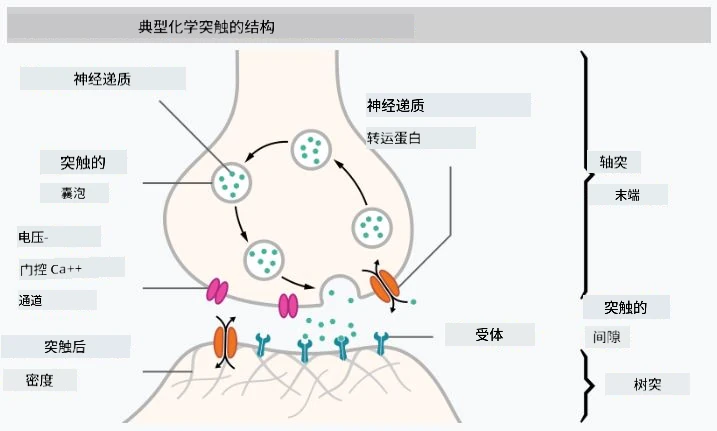
从生物学中我们知道,大脑由神经细胞(神经元)组成,每个神经元有多个“输入”(树突)和一个“输出”(轴突)。树突和轴突都可以传导电信号,它们之间的连接——称为突触——可以表现出不同程度的导电性,这种导电性由神经递质调节。
 |
 |
|---|---|
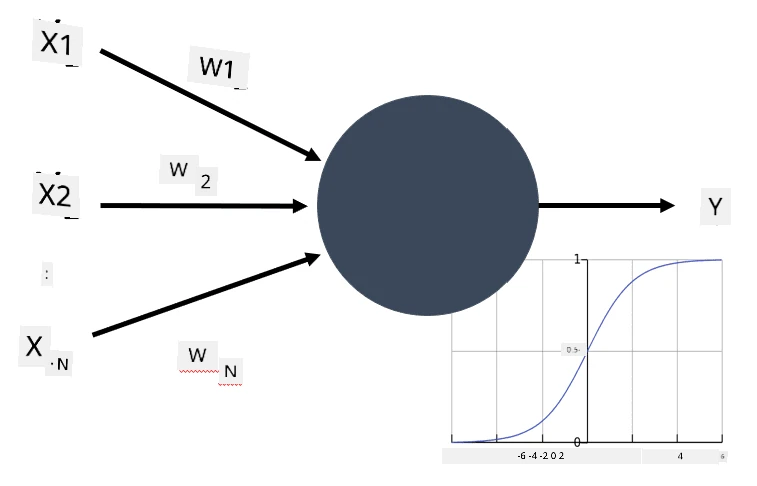
| 真实神经元 (图片来自维基百科) | 人工神经元 (作者提供图片) |

因此,神经元的最简单数学模型包含若干输入 X1, ..., XN 和一个输出 Y,以及一系列权重 W1, ..., WN。输出的计算公式为:
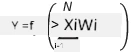
其中 f 是某种非线性的激活函数。
早期的神经元模型在 Warren McCullock 和 Walter Pitts 于1943年发表的经典论文 《A logical calculus of the ideas immanent in nervous activity》 中被描述。Donald Hebb 在他的书《The Organization of Behavior: A Neuropsychological Theory》中提出了训练这些网络的方法。
课前测验
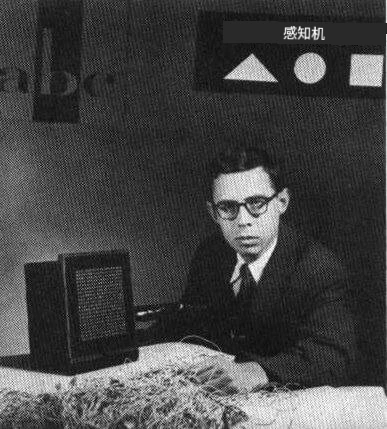
1957年,康奈尔航空实验室的Frank Rosenblatt首次尝试实现类似现代神经网络的模型。这是一种名为“Mark-1”的硬件实现,设计用于识别简单的几何图形,例如三角形、正方形和圆形。
 |
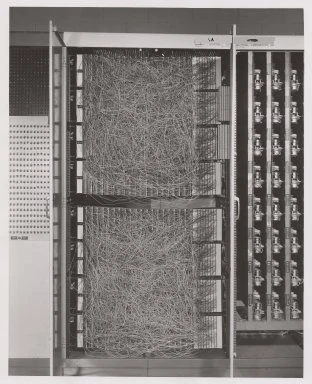 |
图片来源:维基百科
输入图像由20x20的光电池阵列表示,因此神经网络有400个输入和一个二进制输出。一个简单的网络包含一个神经元,也称为阈值逻辑单元。神经网络的权重类似于电位器,在训练阶段需要手动调整。
✅ 电位器是一种允许用户调整电路电阻的设备。
《纽约时报》当时对感知机的报道是:一种电子计算机的胚胎,[海军]期望它能够行走、说话、看见、写作、自我复制并意识到自己的存在。
感知机模型
假设我们的模型有N个特征,那么输入向量将是一个大小为N的向量。感知机是一种二分类模型,即它可以区分两类输入数据。我们假设对于每个输入向量x,感知机的输出将是+1或-1,具体取决于类别。输出通过以下公式计算:
y(x) = f(wTx)
其中f是一个阶跃激活函数
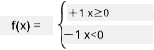
训练感知机
为了训练感知机,我们需要找到一个权重向量w,使得大多数值能够被正确分类,即使误差最小化。这个误差E通过感知机准则定义如下:
E(w) = -∑wTxiti
其中:
- 求和是在那些导致错误分类的训练数据点i上进行的
- xi是输入数据,ti对于负样本是-1,对于正样本是+1。
这个准则被视为权重w的函数,我们需要对其进行最小化。通常使用一种称为梯度下降的方法,我们从一些初始权重w(0)开始,然后在每一步根据以下公式更新权重:
w(t+1) = w(t) - η∇E(w)
这里η是所谓的学习率,∇E(w)表示E的梯度。计算梯度后,我们得到:
w(t+1) = w(t) + ∑ηxiti
Python中的算法如下:
def train(positive_examples, negative_examples, num_iterations = 100, eta = 1):

    weights = [0,0,0] # Initialize weights (almost randomly :)

    for i in range(num_iterations):
        pos = random.choice(positive_examples)
        neg = random.choice(negative_examples)

        z = np.dot(pos, weights) # compute perceptron output
        if z < 0: # positive example classified as negative
            weights = weights + eta*weights.shape

        z  = np.dot(neg, weights)
        if z >= 0: # negative example classified as positive
            weights = weights - eta*weights.shape

    return weights
总结
在本课中,你学习了感知机,这是一种二分类模型,并了解了如何通过使用权重向量来训练它。
🚀 挑战
如果你想尝试构建自己的感知机,可以试试Microsoft Learn上的这个实验,它使用了Azure ML设计器。
课后测验
复习与自学
要了解如何使用感知机解决一个简单问题以及实际问题,并继续学习,请查看感知机笔记本。
这里还有一篇有趣的关于感知机的文章。
作业
在本课中,我们实现了一个用于二分类任务的感知机,并使用它来区分两个手写数字。在本实验中,你需要完全解决数字分类问题,即确定给定图像最可能对应的数字。