第 33 章:智能家居应用实战
第 33 章:智能家居应用实战
本文整理自 Datawhale 开源项目 datawhalechina/jev-cookbook(CC BY-NC-SA 4.0),源文件:main/07_实战应用。
本章用 12 个可运行项目,把 Jev 放进游戏、控制任务和应用工作流中观察。每个项目都沿同一条链展开:环境提供什么状态 → Jev 判断什么 → 普通代码如何执行与兜底 → 结果怎样回到下一步。
这章不是 12 个彼此无关的 API 示例。前三个游戏展示不同的决策结构,第四个 Jev Games Web 把它们统一呈现;接着三个项目观察闭环控制和网页操作,最后五个项目把同一套边界带到策略游戏、约束求解、模拟器复现和智能家居中。
本章学习路线
- 先看贪吃蛇和扫雷:理解有限动作、规则校验与概率判断的分工。
- 再看迷宫、移动靶、浏览器:观察动作如何改变环境,反馈怎样进入下一轮。
- 最后看斗地主、21 点、数独、Mario 与智能家居:练习识别隐藏信息、约束条件、延迟反馈和代码侧安全边界。
读每个项目时问四个问题:
| 环节 | 要观察的问题 |
|---|---|
| State / Observation | 模型实际看到了哪些状态?哪些信息被隐藏或摘要? |
| Decision | 输出是有限动作、类别,还是候选项分布?有没有“等待 / 拒绝 / 未知”? |
| Policy / Engine | 谁检查动作是否合法、更新状态、执行副作用并处理错误? |
| Feedback | 成功或失败由什么裁定?反馈如何影响下一次判断? |
环境真实状态 → 可见观测 / State → 类型化问题与有限选项 → Jev 输出选择或概率
      ↑                                                                   ↓
      └── 环境裁定结果 ← 执行动作 ← 普通代码做合法性与权限检查 ←──────
                                             └─ 非法 / 高风险 / 低置信:拒绝、重试或人工处理
在不完全信息游戏里,环境真值和代理观测不能混为一谈。比如斗地主裁判可以知道全部手牌,策略只能看到自己的手牌和公开出牌;把对手的暗牌传给模型,再把胜率当成可部署结果,会造成信息泄漏。这个区分来自部分可观测决策过程(POMDP)的基本设定,可参考 Kaelbling、Littman 与 Cassandra(1998)。
项目总览
| # | 项目 | 类型 | 主要观察点 |
|---|---|---|---|
| 1 | Gridloop / 贪吃蛇 | 实时游戏 | 局部观测、动作合法性、碰撞反馈 |
| 2 | 扫雷 | 逻辑游戏 | 数字约束、确定性规则与风险概率 |
| 3 | 狼人杀 | 多轮博弈 | 公开证据、角色隐藏、置信度与发言来源 |
| 4 | Jev Games Web | React 统一入口 | 游戏入口、对照实验、trace 展示 |
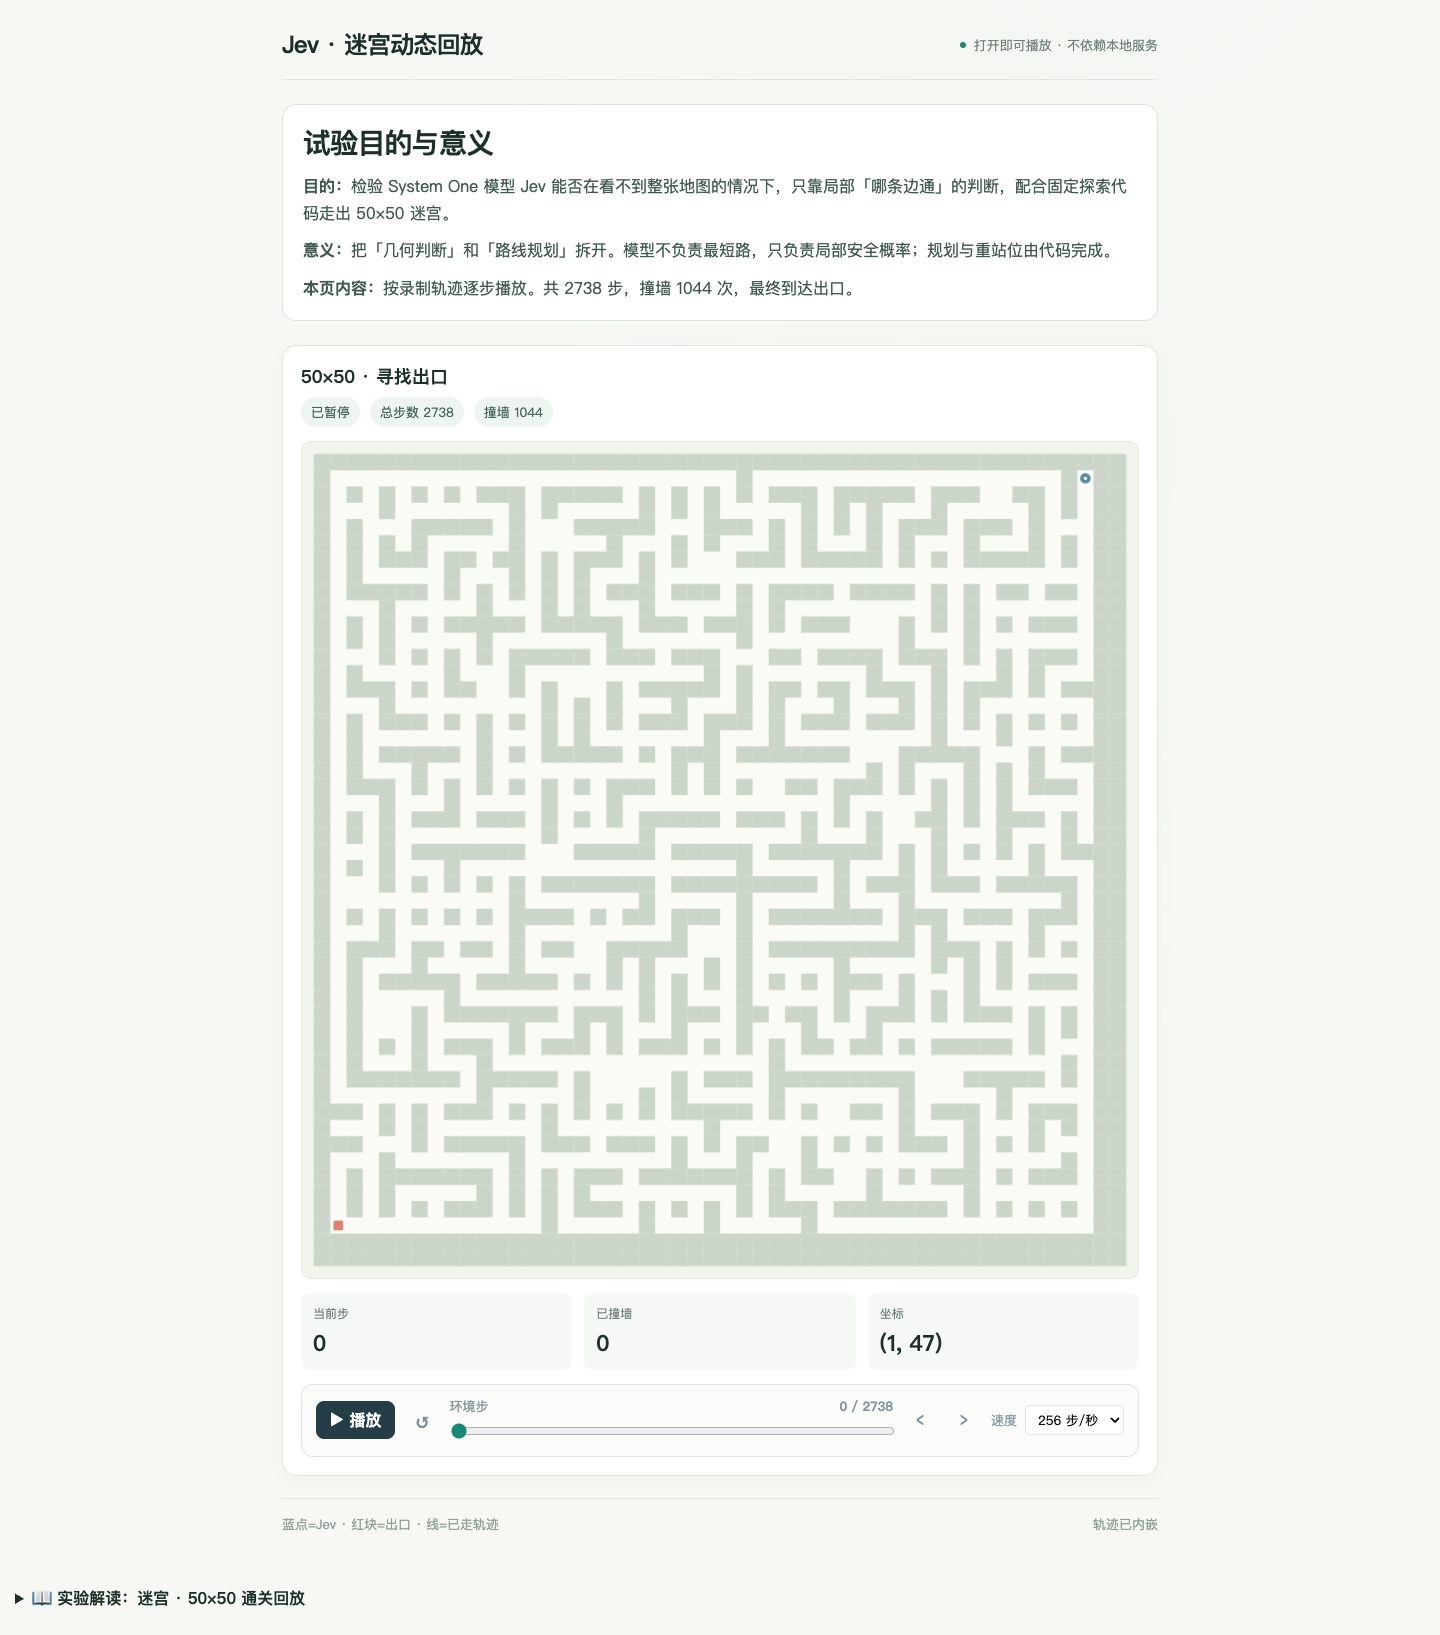
| 5 | 迷宫 | 闭环控制 | 局部判断与代码规划分离 |
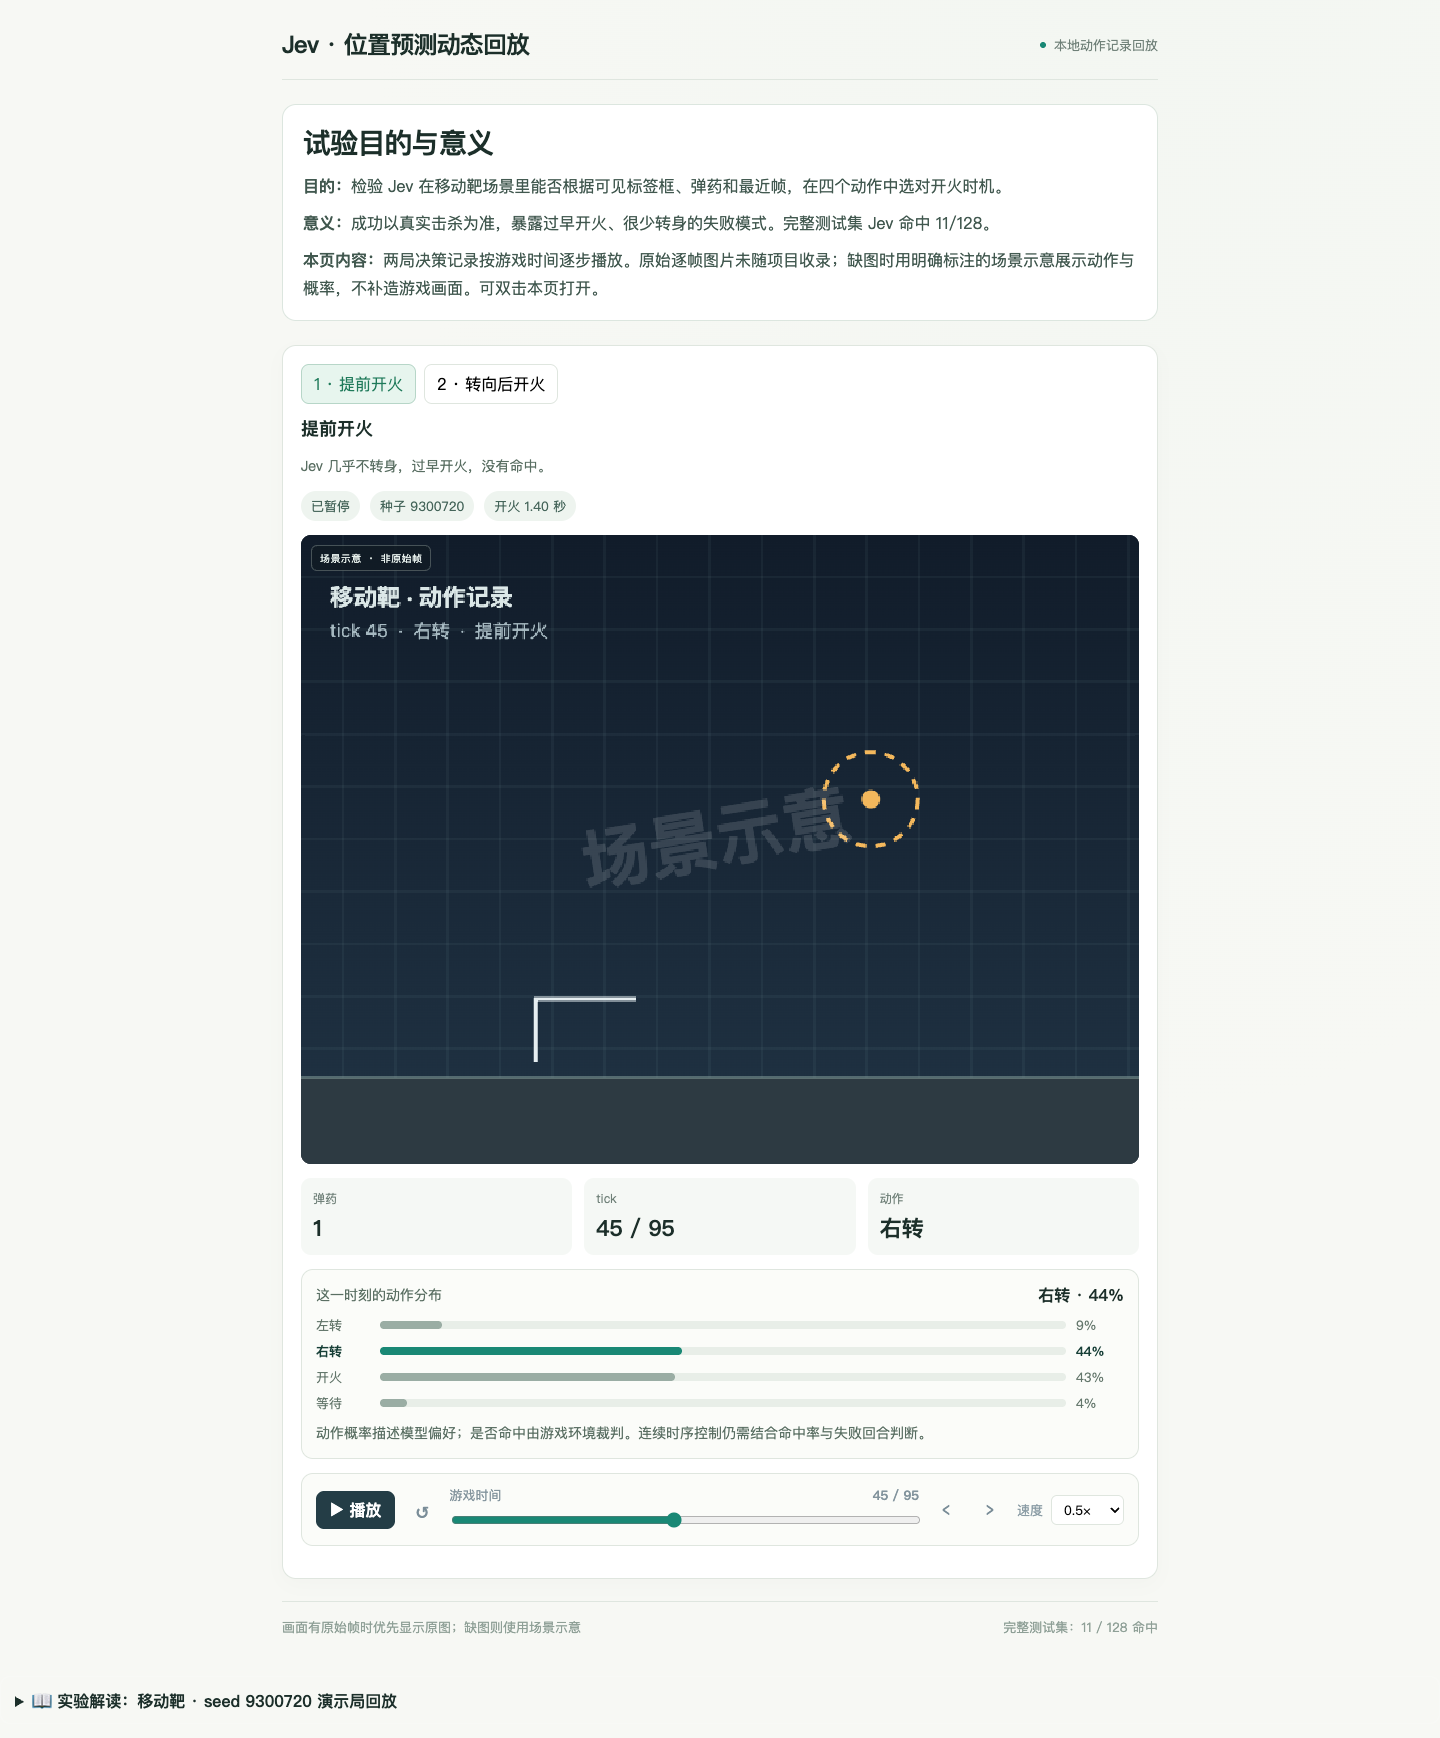
| 6 | 移动靶 / 位置预测 | 连续控制 | 时序、转向、开火与命中反馈 |
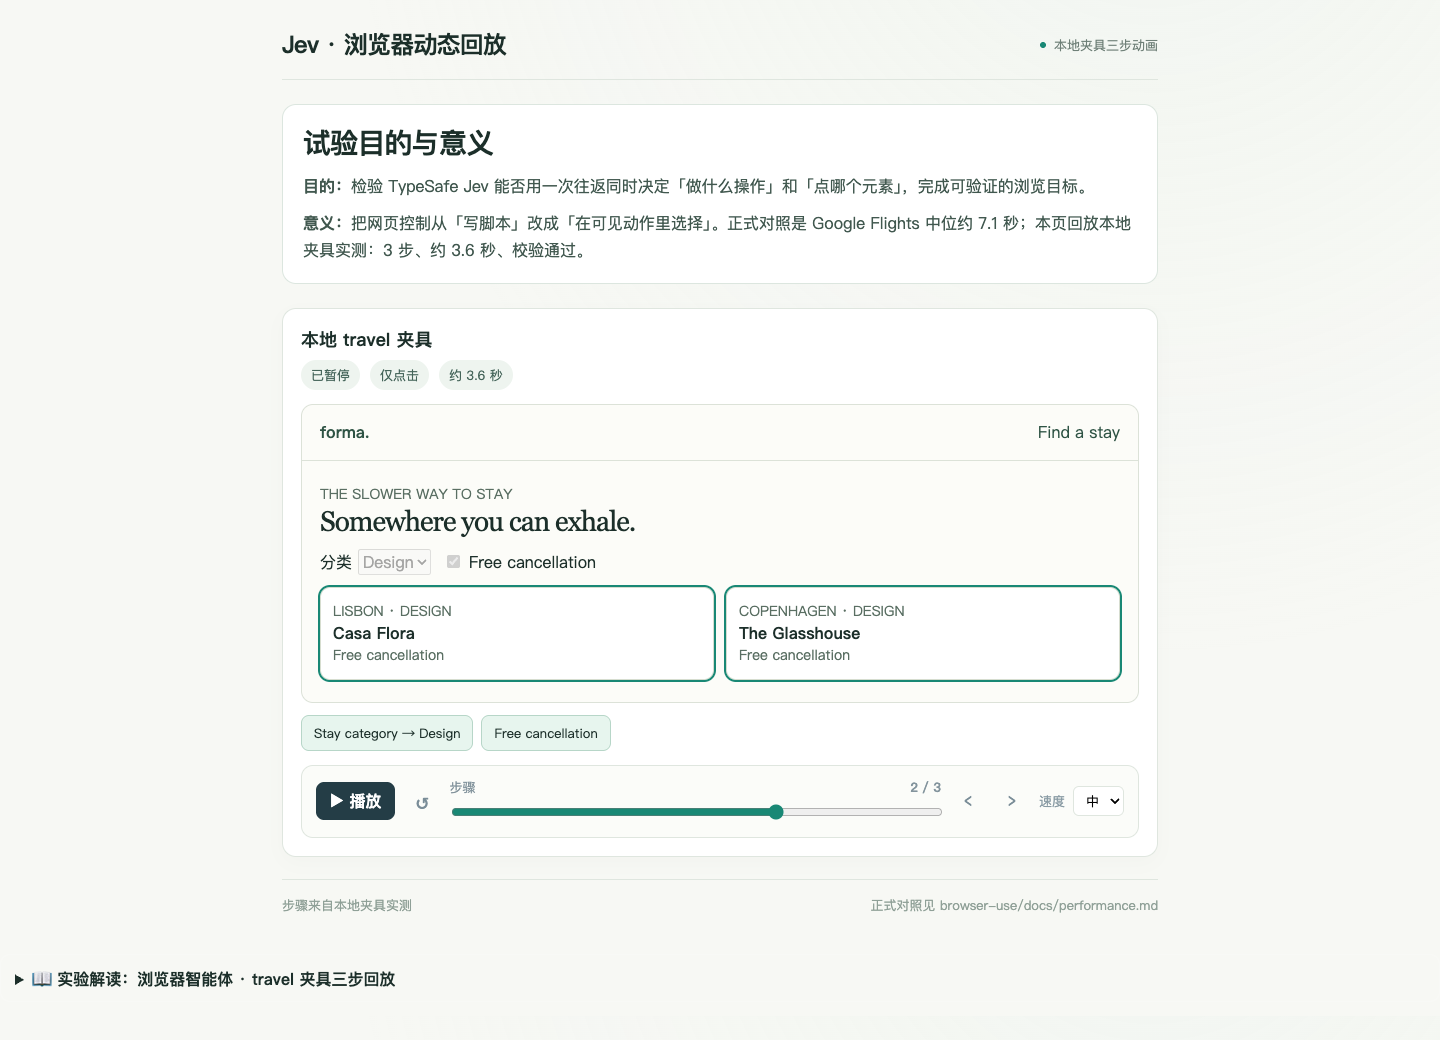
| 7 | Browser Use | 网页智能体 | 选择操作与目标元素、执行后校验 |
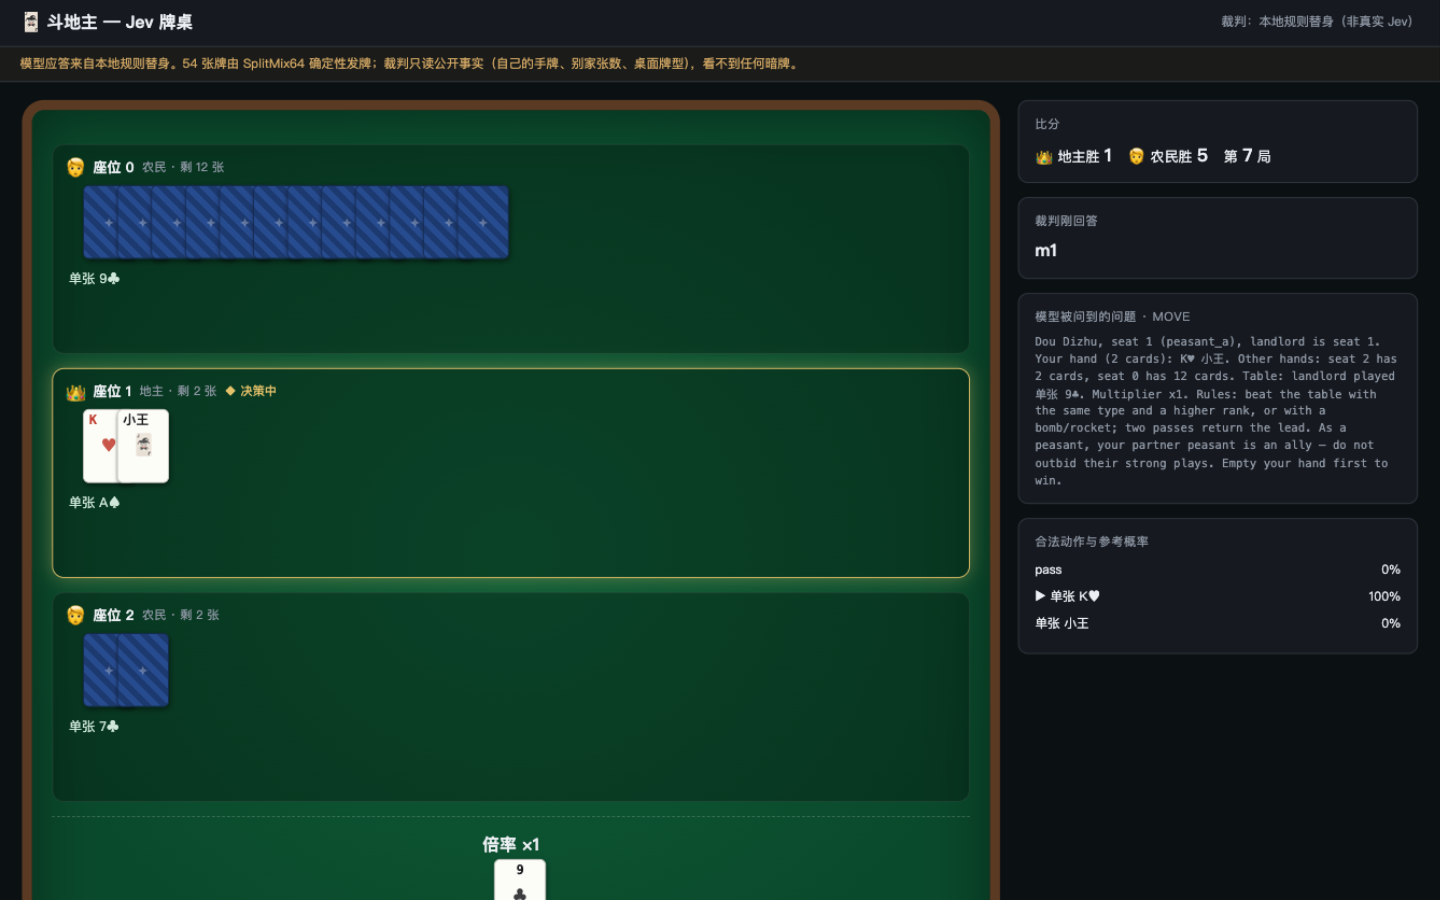
| 8 | 斗地主 | 不完全信息博弈 | 暗牌隔离、合法牌型与队友配合 |
| 9 | 21 点 | 概率策略 | 牌靴组成、爆牌风险、资金曲线 |
| 10 | 数独 | 约束求解 | 行列宫约束、候选集、试错记忆 |
| 11 | Mario 复现 | 模拟器控制 | 帧同步、动作持续时间、环境混杂因素 |
| 12 | 智能家居 | 应用工作流 | 意图路由、投机提示、确定性派发 |
项目展示
1. Gridloop / 贪吃蛇
看点: 每一步都是方向选择,但动作是否安全要由游戏环境判断。读图时关注蛇身、食物、自动驾驶提示和回合状态;不要把一次长回合等同于策略已具备泛化能力。
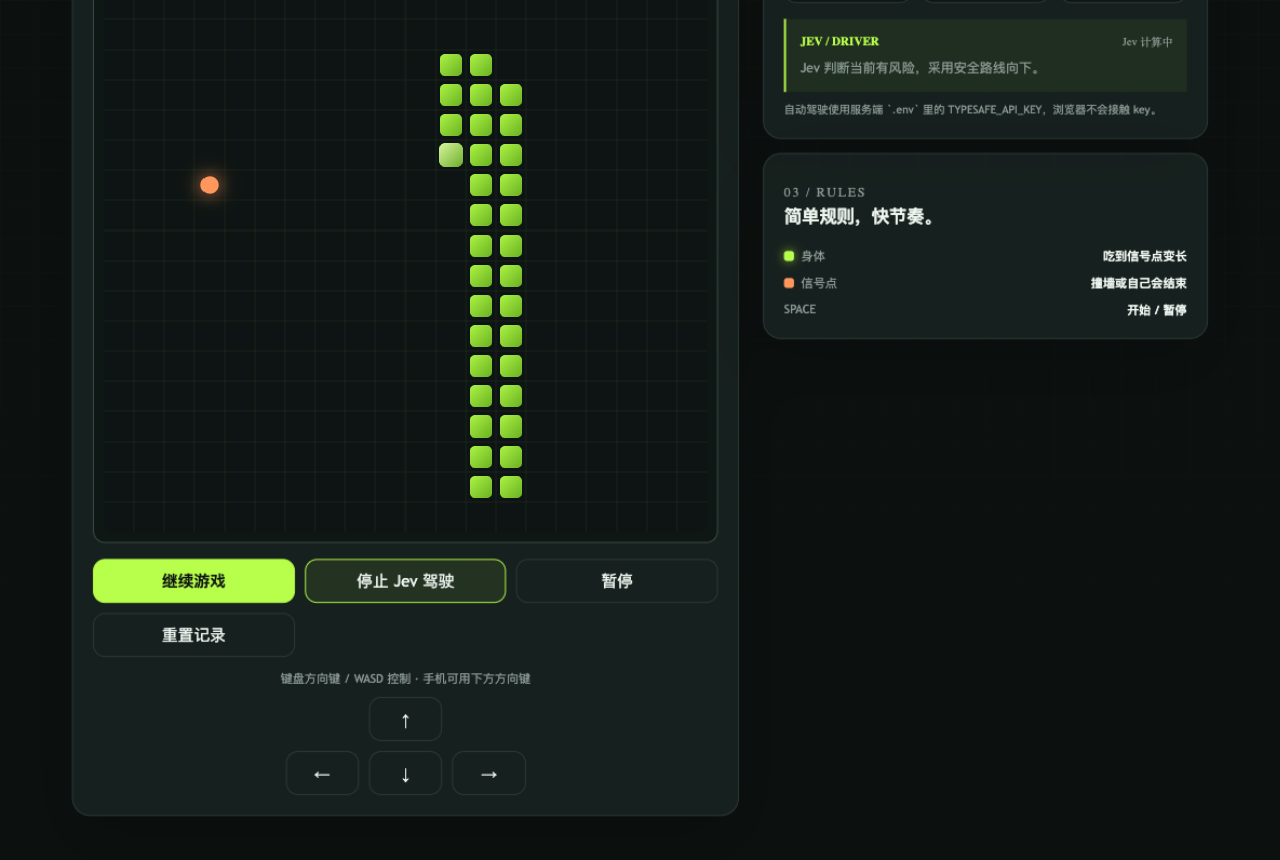
- 项目代码与说明
- 边界: 模型给方向判断;碰撞、吃到食物、得分和状态更新由游戏规则负责。
2. 扫雷
看点: 已打开数字格提供邻域约束,旗子与未翻开的格子则构成风险选择。要区分“规则已能确定安全”和“模型只是在多个候选中选风险较低的一格”。
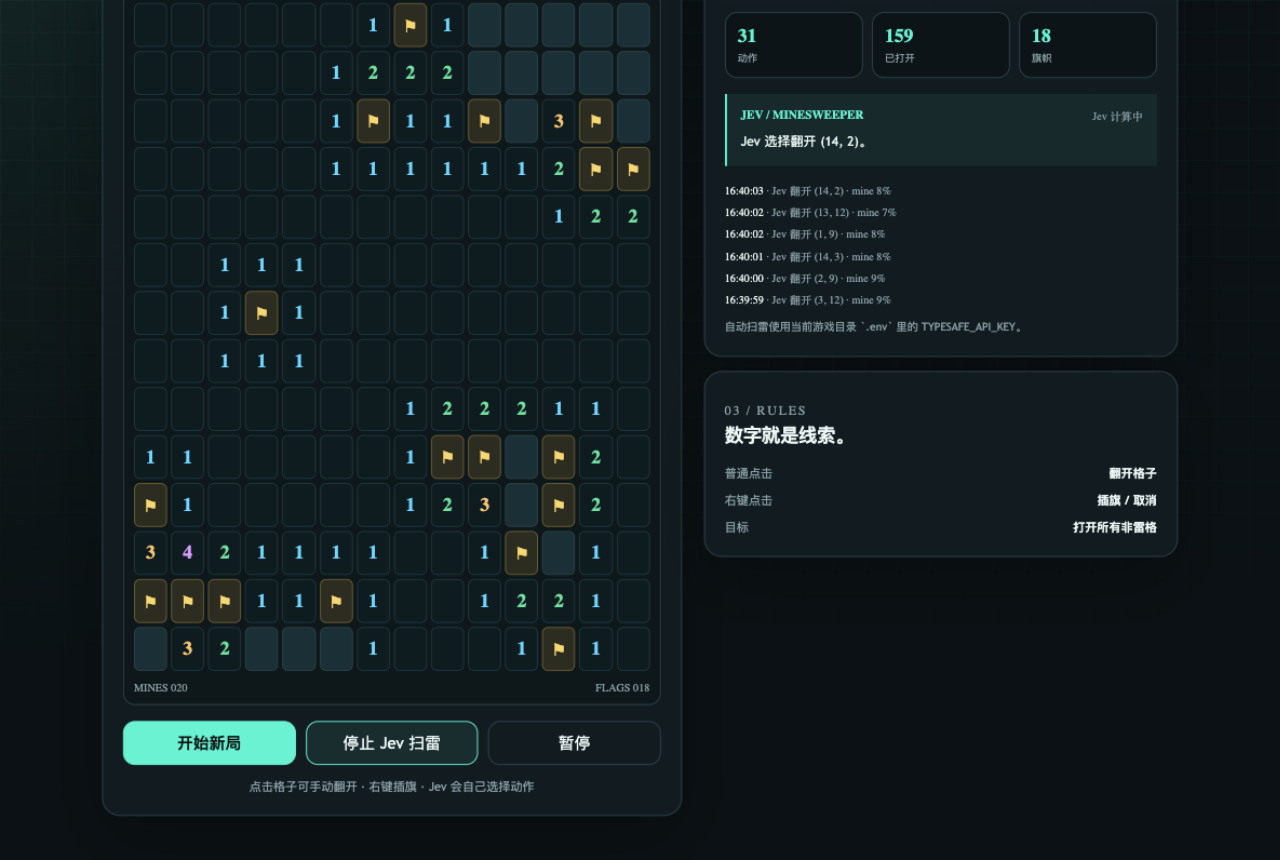
- 项目代码与说明
- 边界: 界面里的概率或选择不替代扫雷规则;是否踩雷由棋盘状态裁定。
3. 狼人杀
看点: 每轮发言和投票都改变后续信息。观察玩家卡片中的最近判断、证据与身份状态,特别留意界面标出的模板 fallback:模板发言不是模型生成内容,不能把它当作 Jev 的语言能力证据。
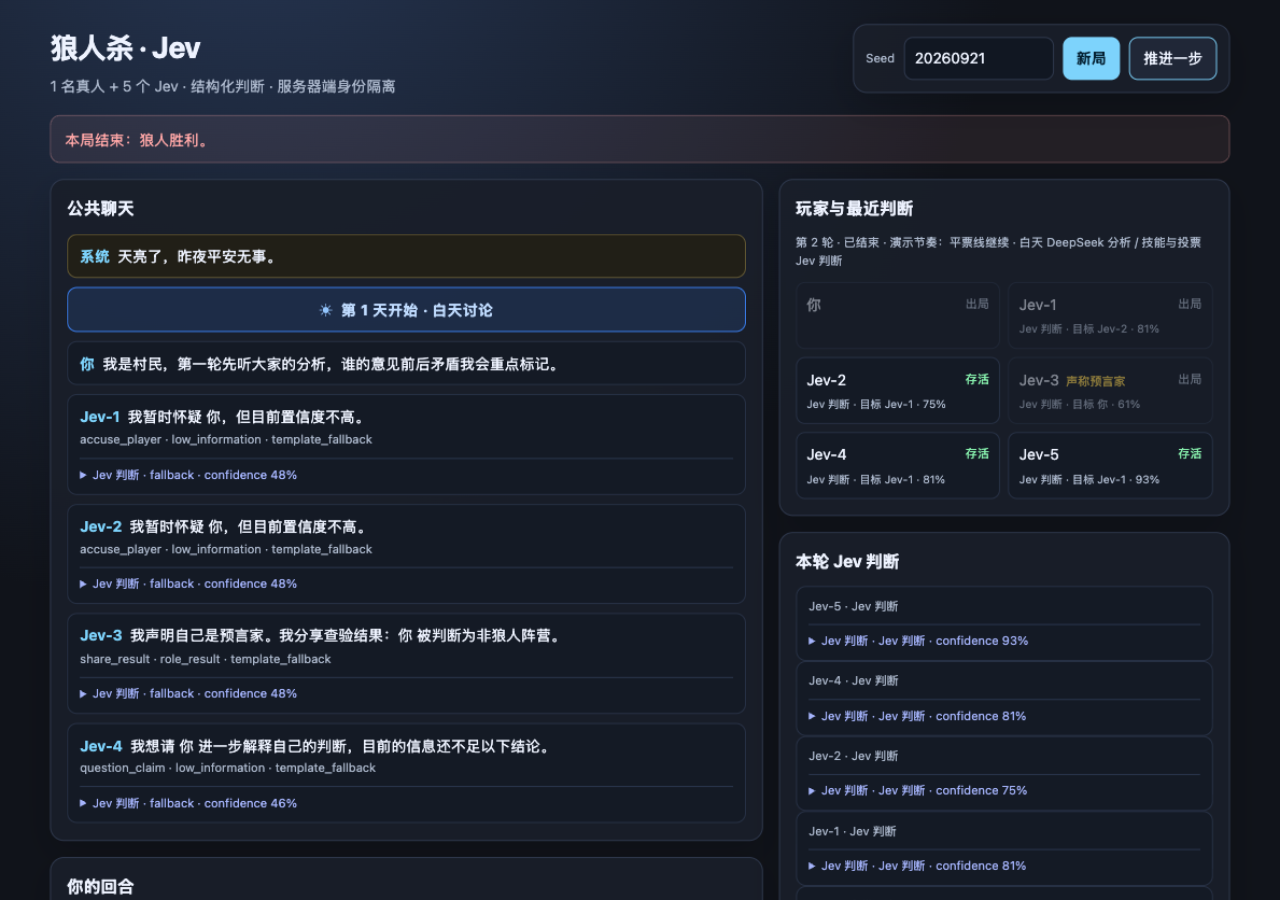
- 项目代码与说明
- 边界: 身份是隐藏信息;复盘只能使用当时可见的发言和公开事件。
4. Jev Games Web:统一入口
看点: React 页面把游戏入口和对照实验放在同一个导航里,便于比较原始策略与接入决策模型后的 trace。它是前三个游戏的入口,不是额外一种游戏策略。
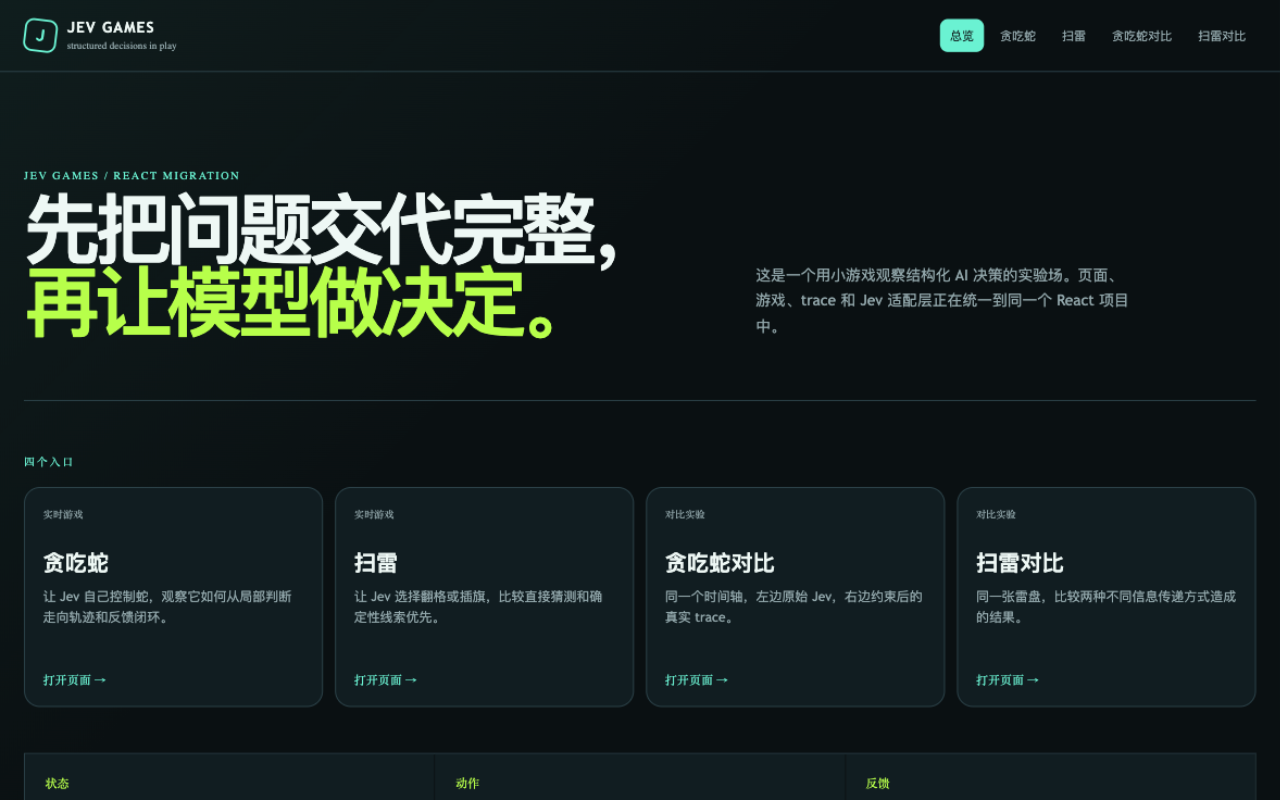
- Web 项目代码 · 上游 jev-games
- 边界: 入口页负责组织展示;实际动作、规则和结果分别由各游戏引擎裁定。
5. 迷宫:闭环导航
看点: 模型看局部窗口并判断相邻方向是否安全,路线搜索、重站位和物理碰撞仍由代码处理。截图中的 50×50、2738 步、1044 次撞墙是这段冻结回放的记录,适合用来观察反馈成本,而不是只看“最终到达出口”。
6. 移动靶 / 位置预测
看点: 可选动作包括左转、右转、开火和等待。模型给出的动作概率不等于命中概率;命中必须由游戏环境确认。完整测试集记录为 11 / 128 命中,报告分析了过早开火、转向不足等失败模式。
7. Browser Use:网页智能体
看点: 每个步骤分别选择“做什么操作”和“操作哪个元素”,执行器只消费可见元素索引;最后还要通过独立校验确认目标完成。下图是本地 travel 夹具的中间步骤,页面可拖动时间轴继续看完三步。
8. 斗地主
看点: 桌面展示公开牌局,玩家手牌只属于当前玩家观测;右侧可以对照裁判回答、动作问题和合法候选。图中标明的是本地规则替身,不是真实 Jev 在线调用。
9. 21 点
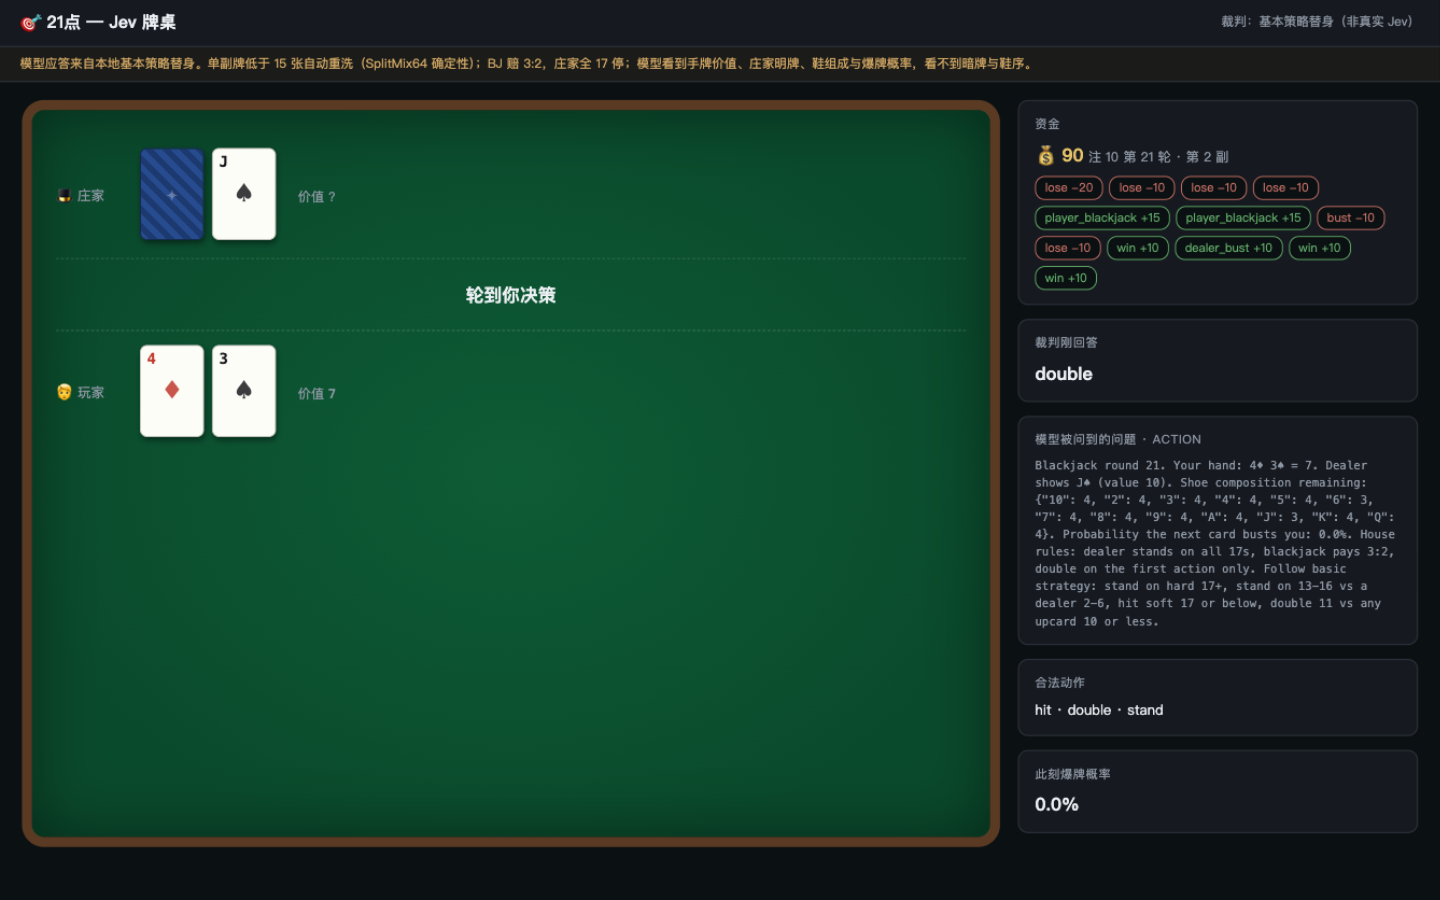
看点: 当前手牌、庄家明牌、剩余牌靴组成和爆牌风险共同影响 hit / stand / double 等动作。资金曲线是策略结果的一部分;比较时要使用同一牌靴规则、初始资金和随机种子。
10. 数独
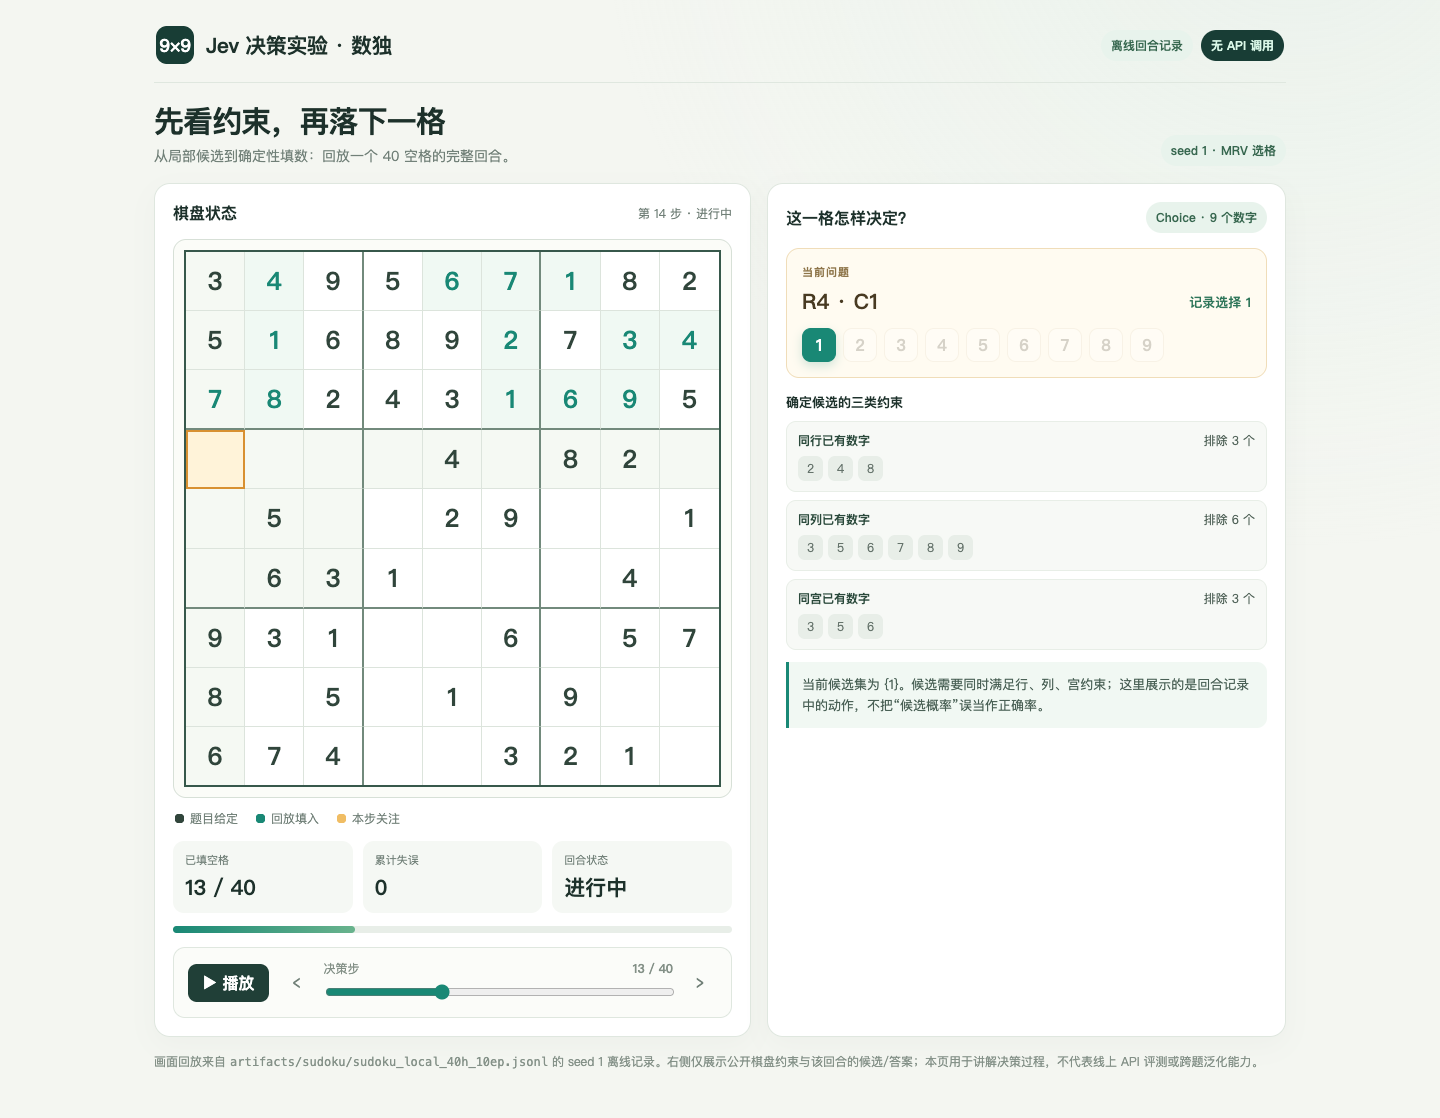
看点: 先由 MRV(最少候选优先)选格,再结合同行、同列、同宫排除数字。时间轴可以逐步回放本地裁判记录;右侧展示的是候选约束和本步记录答案,不把候选概率冒充成“答对概率”。
11. Mario 复现:模拟器闭环
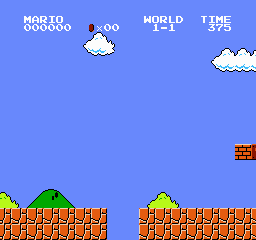
看点: 参考上游 typesafe-mario,沿着“内存遥测 → 结构化 state → Choice 选择控制宏 → Python 推进模拟器 → 新状态反馈”看完整决策闭环。NES 截图只供人观察;原始 local_grid 只用于调试,解析后的地形与危险字段才进入 state。按键边沿、相机滚动和每拍推进帧数都会影响闭环表现。
- 本地案例说明 · 八节实验报告 · 完整排查记录
- 边界: 浏览器页面默认使用本地 scripted pilot,Choice / Noul / Score 数值不是 Jev 输出。按键与模拟器现象可作为工程观察,模型表现需运行上游项目的真实 Jev 路径后单独评测。
12. 智能家居:从判断到设备派发
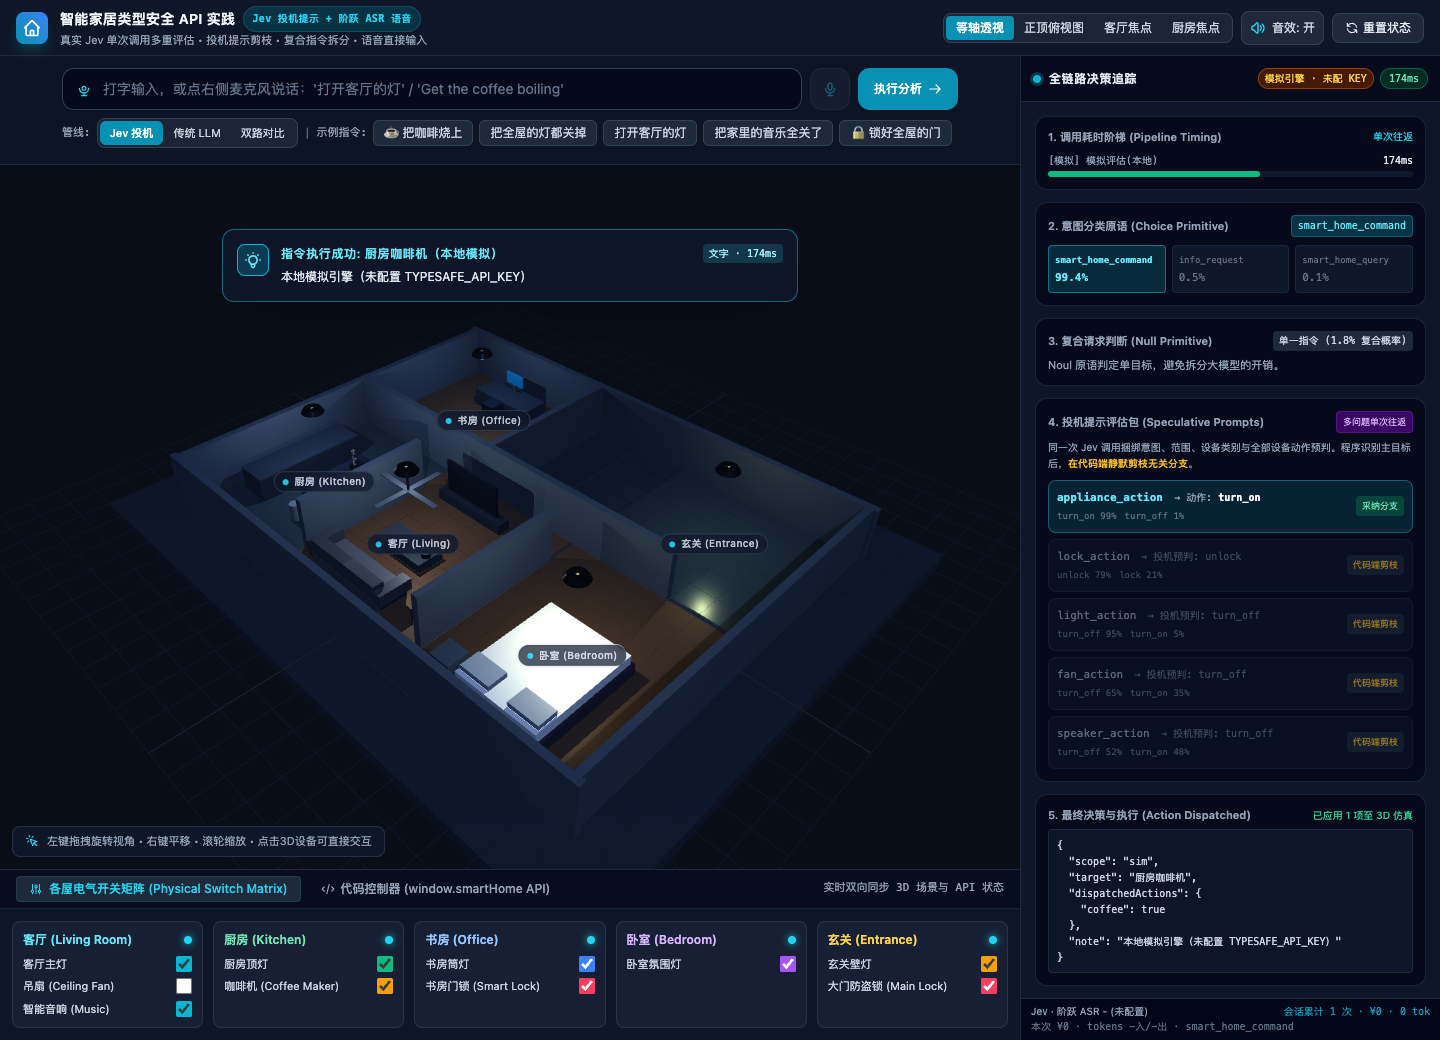
看点: 从自然语言输入开始,依次观察意图、类型化问题、投机动作、无关分支剪枝、确定性派发和 3D 设备状态。截图明确显示“模拟引擎 · 未配 KEY”,用于讲数据流和 UI,不是一次真实 API 延迟或成本测量。
运行与复盘
本章项目混合了静态回放、离线裁判、UI 模拟和可选在线 API:
- 零密钥阅读: 先读各项目 README 与实验报告,并打开 maze/final.html、predict_position/final.html、browser-use/final.html 和 sudoku/sudoku_replay.html 查看本地回放。数独回放直接展示离线记录;移动靶在缺少逐帧原图时明确切换到场景示意。
- 需要运行服务时: 按具体项目 README 和统一测试指南启动单个项目。不要把启动了网页等同于已经完成在线模型验证。
- 需要在线 API 时: 先检查项目说明中的模型、密钥和成本要求;不要把密钥写入代码或截图。智能家居和浏览器 smoke 的在线路径可能触发真实请求。
- 看实验结果时: 区分样例回放、离线规则裁判、mock、模板 fallback 与真实模型响应;成功判定应以项目裁判和冻结测试集指标为准。
本章总结
12 个项目覆盖三类不同问题:局部游戏判断(贪吃蛇、扫雷、狼人杀;由 Jev Games Web 统一展示),动作闭环与工具控制(迷宫、移动靶、浏览器),以及结构化策略落地(斗地主、21 点、数独、Mario、智能家居)。共同的方法不是“让模型接管一切”,而是把判断题做成有限、可观测的决策,再由普通代码承担规则、权限、执行和反馈。
来源与许可
- Gridloop、扫雷、狼人杀与 Jev Games Web 收录自 jev-games。上游仓库未附 LICENSE;版权归原作者,收录仅供学习参考。
- 其余项目按项目内声明与 jev-playground 的 CC0-1.0 约定收录。Browser Use 与 Mario 复现另见各自项目内的来源说明。
- 改动或再分发前检查具体项目的 LICENSE 与来源说明;仓库级设计见 app/ARCHITECTURE.playground.md。
本笔记本分四部分:① 官方案例讲解 → ② 实现原理与逻辑 → ③ 我们的实验 → ④ 启动 Web 端体验(末尾把整个 3D 应用内嵌进笔记本)。
运行前置:本目录下已启动 serve_smart_home.py(第 4 节的启动单元格也可以一键拉起)。
① 官方案例讲解
TypeSafe 官方的智能家居演示(教学视频)做了四件事:
- 单次调用多重评估:用户说 "get the coffee boiling",系统只调用 TypeSafe API 一次, 却在同一发请求里塞进一大批问题:意图是什么?是不是复合指令?作用范围?哪类设备?哪个具体设备?
- choice 原语定意图:
choice返回每个选项的概率分布—— smart_home_command 99% / info_request / smart_home_query,取 argmax 后由代码分支。 - 投机提示(Speculative Prompting):明明只涉及咖啡机,也"顺带"问了门锁——返回 "79% unlock / 21% lock"这种不确定分布。视频里的原话是:反正快且便宜,问都问了, 真用到门锁的指令来时就不用再跑一趟。代码端剪枝掉不相关的答案即可。
- 该出手的才出手:复合指令("关厨房灯然后锁书房门",复合概率 98%)先用 178ms 的 TypeSafe 初筛,再交 Claude Haiku 拆成两条原子指令,并行回 TypeSafe 评估; 常识问题("1989 世界大赛冠军")则路由给大模型回答——快而确定的走 Jev,开放式的走 LLM。
② 实现原理与逻辑
2.1 一次请求长什么样
POST /v1/systemone,请求 = state(当前世界状态)+ questions(问题包);
回复 = 每个问题的答案,带完整概率分布:
import json, urllib.request

payload = {
  "state": {"utterance": "把咖啡烧上", "home": {"rooms": ["living_room", "kitchen"]}},
  "model": "jev-latest",
  "questions": {
    "intent": {"type": "choice", "criteria": {
        "smart_home_command": "控制设备", "information_request": "与家居无关的常识"}},
    "category": {"type": "choice", "criteria": {
        "lighting": "灯", "appliance": "家电", "not_device_specific": "不涉及"}},
    "appliance_action": {"type": "choice", "criteria": {
        "turn_on": "打开", "turn_off": "关闭", "leave_unchanged": "保持"}}
  }
}
req = urllib.request.Request("http://127.0.0.1:8810/api/jev",
    data=json.dumps(payload).encode(), headers={"Content-Type": "application/json"})
wire = json.loads(urllib.request.urlopen(req, timeout=20).read())
print(f"上游耗时 {wire['upstream_ms']}ms")
for name, a in wire["body"]["answers"].items():
    dist = a.get("probabilities") or {"noul": a.get("noul")}
    print(f"  {name:18s} -> {a.get('choice', '—'):22s} {json.dumps(dist, ensure_ascii=False)}")
上游耗时 201ms
intent -> smart_home_command {"smart_home_command": 0.97, "information_request": 0.02, "smart_home_query": 0.01}
is_compound -> — {"noul": 0.074}
scope -> specific_device {"whole_house": 0.05, "single_room": 0.05, "specific_device": 0.9}
target_room -> not_room_specific {"living_room": 0.02, "kitchen": 0.02, "office": 0.02, "bedroom": 0.02, "entrance": 0.02, "not_room_specific": 0.9}
category -> appliance {"lighting": 0.02, "appliance": 0.902, "lock": 0.02, "fan": 0.02, "speaker": 0.02, "not_device_specific": 0.02}
light_action -> turn_on {"turn_on": 0.942, "turn_off": 0.029, "leave_unchanged": 0.029}
fan_action -> turn_on {"turn_on": 0.907, "turn_off": 0.047, "leave_unchanged": 0.047}
speaker_action -> turn_on {"turn_on": 0.906, "turn_off": 0.047, "leave_unchanged": 0.047}
appliance_action -> turn_on {"turn_on": 0.908, "turn_off": 0.046, "leave_unchanged": 0.046}
lock_action -> lock {"lock": 0.919, "unlock": 0.041, "leave_unchanged": 0.041}2.2 三种原语就是全部词汇
| 原语 | 回答什么 | 返回 |
|---|---|---|
choice |
多选一(意图/设备类别/动作) | argmax + 全分布 + 置信 |
noul |
是/否(复合吗?A 必须先于 B 吗?) | 一个 0~1 概率 |
score |
有序评分(优先级/紧急度) | 期望分 + 各档概率 |
没有文本生成、没有对话——所以快、便宜、输出天然结构化。开放式的活再转包给大模型。
2.3 我们页面里的完整管线
指令 ──► ① Jev 投机调用(10 问捆绑:意图/复合/范围/房间/类别 + 五类设备动作)
          ├─ intent=信息请求 ──► step-3.5-flash 直答(Jev 只当 141ms 的路由守卫)
          ├─ intent=状态查询 ──► 投机答案定位 + 本地 3D 状态直读(零额外调用)
          └─ intent=控制指令
               ├─ is_compound ≥ 50% ──► LLM 拆原子指令
               │      └─ ② Jev 编排调用:每对子指令 noul「A 必须先于 B 吗」
               │           + 每条 score 优先级(安全最先)
               │           任一依赖 ≥60% → 串行执行栈(拓扑序逐个派发)
               │           全部 <60%    → 并行执行
└─ 单一指令 ──► 直接取投机答案里相关类别的动作派发(剪枝其余)串行/并行的意义:「先开客厅灯再关掉」两步作用于同一设备,顺序决定最终状态 → 必须串行; 「关厨房灯 + 锁书房门」互不相关 → 并行省时间。依赖判定这件事本身也交给 Jev 的原语完成。
③ 我们的实验:智能家居 3D 演练场
参考官方案例 UI 复刻的 Three.js 三维户型(客厅/厨房/书房/卧室/玄关,设备可点选), 把演示视频里的"假数据"全部换成真实调用:
- 语音直接输入:阶跃星辰流式 ASR(
stepaudio-2.5-asr,16k 裸 PCM,首字 ~0.52s), 中英文自动检测;打字输入保留。 - 串行/并行任务编排:同灯先开后关判 93% 依赖 → 串行栈执行,最终灯为关(顺序保持); 异类指令并行 + 按优先级排序。编排分析仅 133–141ms。
- 传统 LLM 对照:一键切换 step-5-preview 一次直答做同样的事——JSON 遵从完美, 但延迟 3–20×、每单多几百输出 token(页面右下角实时显示成本:Jev 输入 $0.042/M、输出免费)。
- 无 Key 降级:不设
TYPESAFE_API_KEY自动切本地模拟引擎,功能照常。
实测明细见 README.md。
④ 启动 Web 端 + 内嵌体验
可以内嵌:我们的本地服务不发 X-Frame-Options,Jupyter 里直接用 <iframe> 即可。
注意要加 allow="microphone",否则框里麦克风会被浏览器禁掉。
import subprocess, sys, time, urllib.request, os
from pathlib import Path

PORT = 8810
BASE = f"http://127.0.0.1:{PORT}"

def server_up():
    try:
        return urllib.request.urlopen(f"{BASE}/api/health", timeout=2).status == 200
    except Exception:
        return False

if not server_up():
    env = dict(os.environ)
    subprocess.Popen([sys.executable, "serve_smart_home.py", "--port", str(PORT),
                      "--host", "127.0.0.1", "--no-open"],
                     cwd=str(Path.cwd()), env=env,
                     stdout=subprocess.DEVNULL, stderr=subprocess.DEVNULL)
    for _ in range(30):
        if server_up():
            break
        time.sleep(0.5)

import json
health = json.loads(urllib.request.urlopen(f"{BASE}/api/health", timeout=2).read())
print("服务状态:", "运行中" if server_up() else "启动失败")
print("  真实 Jev :", "已配置" if health["jev"] else "未配置(页面用本地模拟引擎)")
print("  阶跃 ASR :", health["asr_model"] if health["asr"] else "未配置")
服务状态: 运行中
真实 Jev : 已配置
阶跃 ASR : stepaudio-2.5-asrfrom IPython.display import HTML
HTML(f'''
3D 场景可拖拽旋转;麦克风需在
独立标签页打开时体验更稳(部分浏览器限制 iframe 内的录音权限)。
''')尾注
- 代码与实验报告:Bald0Wang/jev-playground → smart-home/
- Jev 定价:输入 $0.042/M tokens、输出免费;阶跃定价见官方
docs/zh/guides/pricing/details - 环境搭建:
TYPESAFE_API_KEY(console.typesafe.ai)、STEPFUN_API_KEY(platform.stepfun.com)